Революция в интерпретируемости? Are neural networks already clean?
14 ноября 2026 г.
Введение и краткое содержание
“Это может оказаться одним из важнейших дней в истории глубокого обучения”, — написал Дин Болл 15 октября. В тот день Ник Каммарата из Goodfire опубликовал большое интерактивное эссе Neural Networks Are Already Clean. Речь в нём шла об интерпретируемости (interpretability), а именно о том, что же на самом деле видят нейроны в больших сетях.
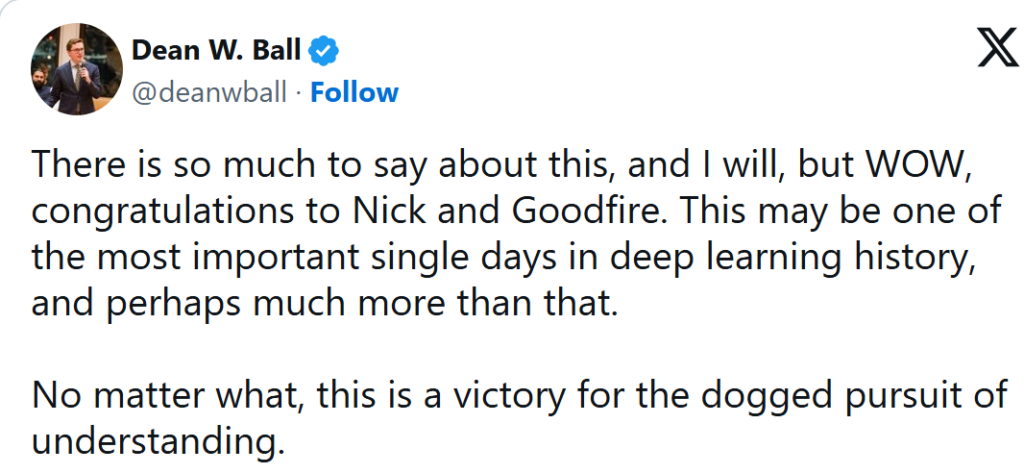
Известный исследователь из OpenAI, roon, тоже был восхищён результатом:
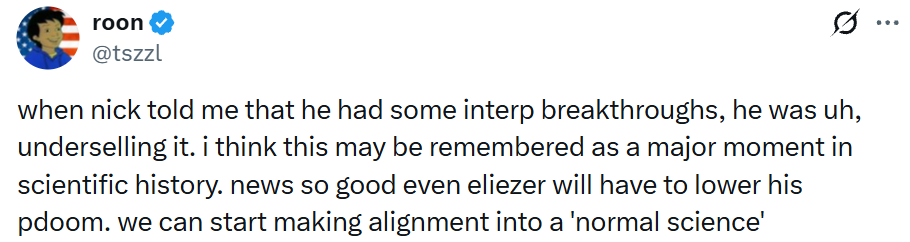
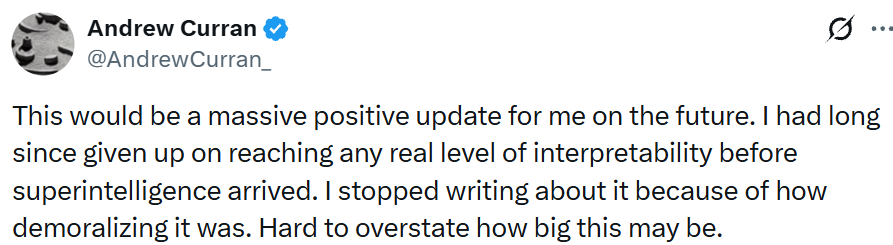
А Эндрю Карран и вовсе написал, что это вернуло ему надежду на успех всей программы интерпретируемости:
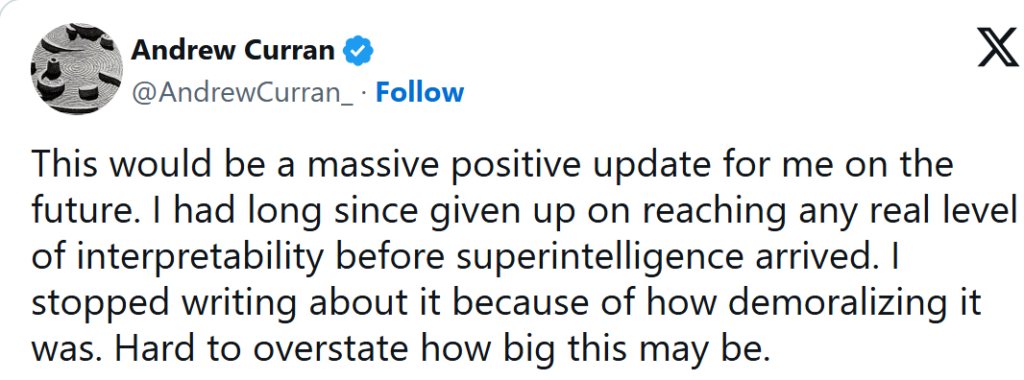
Что же такого замечательного сделал Каммарата? В основе работы лежит вполне эмпирическое утверждение. Если взять отдельный нейрон обученной сети и посмотреть, откуда в него приходит сигнал и кто дальше этим сигналом пользуется, то у неожиданно многих нейронов удаётся выделить основной признак, основное различие между входами, которое они проводят.
Как проверить, что мы верно поняли смысл нейрона? Оказалось, что он довольно часто настолько точно выражается словами, что другой исследователь, получив такое описание, может заранее придумать два почти одинаковых входа, на которые нейрон ответит по-разному. А если удастся разобраться ещё и в связях, можно попытаться предсказать, как изменится ответ всей модели при отключении нескольких таких нейронов.
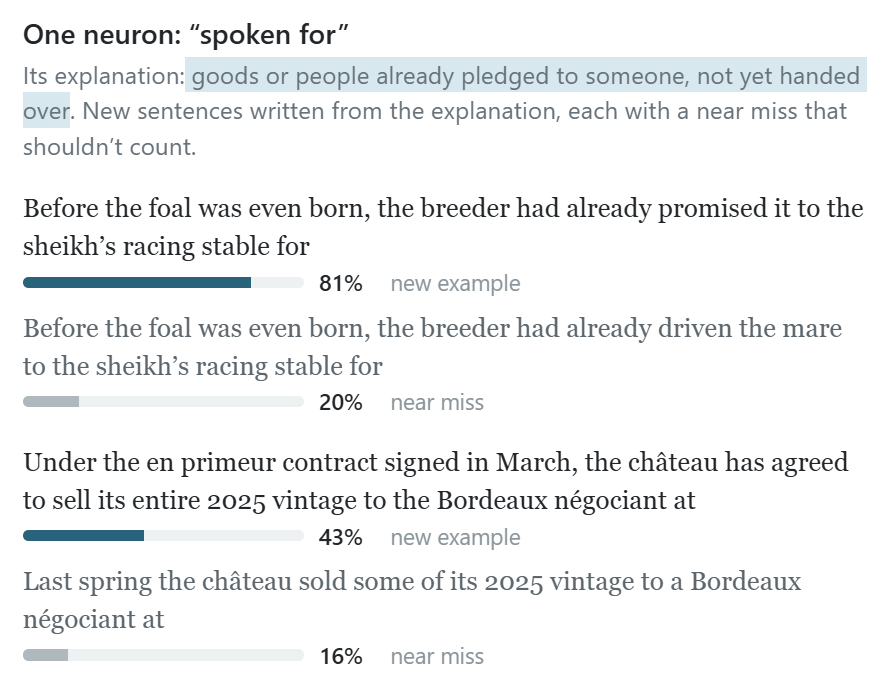
Вот один пример из Qwen3-32B: нейрон был описан текстом как передающий смысл “обещанного”, “spoken for”: “goods or people already pledged to someone, not yet handed over”. Основываясь только на этом описании, агент составил несколько фраз, которые должны были сильно активировать этот нейрон, и несколько других, которые должны были быть “near misses”… и всё так и вышло:
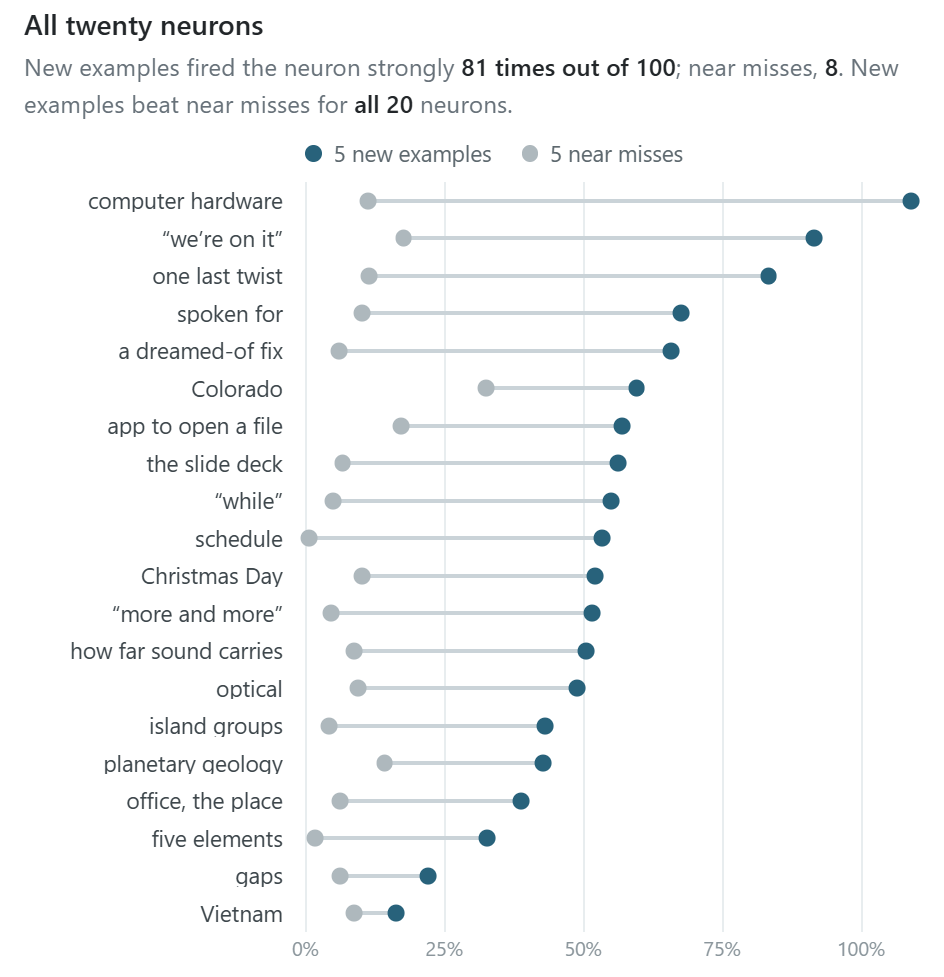
Это ещё не полное описание “мыслительного процесса” языковой модели, но уже большой прогресс на этом пути. И так удалось описать много разных нейронов; вот ещё несколько примеров:
Для самого Каммараты это довольно радикальная смена взглядов. В 2020 году сам Каммарата и его соавторы в журнале Distill рассматривали классическую свёрточную сеть InceptionV1. В одном из её слоёв есть нейрон, который сильно реагирует как на кошачьи морды, так и на автомобили, снятые спереди или в три четверти. Тогда они привели этот нейрон как пример суперпозиции (superposition), того, что в одной координате сеть совмещает несколько разных признаков:
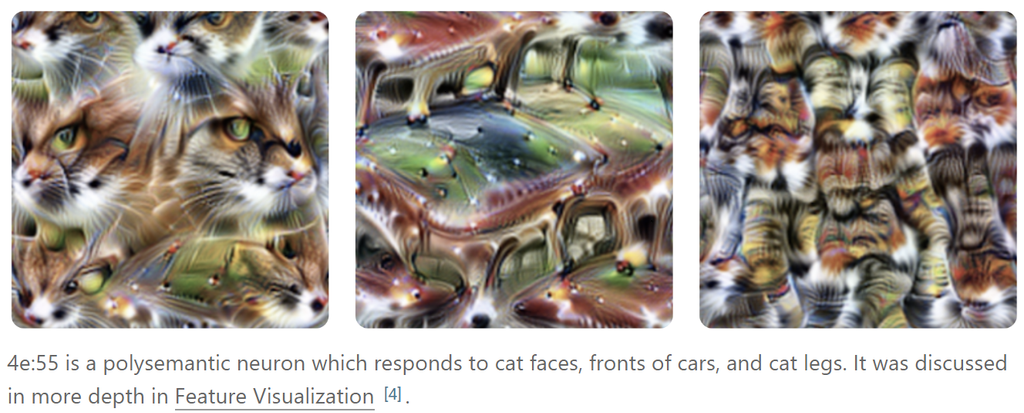
Возможно, сеть экономит место и хранит сведения о кошках и машинах в одних и тех же нейронах, извлекая каждое по отдельности разными схемами. Но вполне возможно и другое. У кошачьей морды и у автомобиля, снятого под определённым углом, есть сходство угловатой формы, полезное сети для дальнейшего распознавания.
Как выбрать между этими объяснениями? Нужно посмотреть, что общего у сигналов, которые сходятся на нашем нейроне, выяснить, куда они идут дальше, и подобрать картинки, на которых гипотезы расходятся в предсказаниях. Так Каммарата возвращается к старому способу изучать нейросети, причём именно он сам в 2020 году привёл один из самых известных доводов против того, что этим способом удастся далеко зайти.
За шесть лет веса InceptionV1, разумеется, не изменились, так что этот спор даёт редкую возможность вернуться к тому же объекту и проверить, что же в действительности объясняет новая гипотеза. Я (с помощью GPT, конечно) это и сделал. Ниже мы увидим собственные карты отклика того самого нейрона на разные картинки. По этим картам хорошо видно и то, откуда у Каммараты возникла идея об общей форме, и то, почему одной буквы V для описания нейрона всё-таки мало.
С языковыми моделями всё ещё интереснее. По предварительной оценке Каммараты и Курта Тиггеса, у примерно 90% исследованных полюсов нейронов Qwen3-32B удаётся назвать одну основную функцию, как в примерах выше. Как получена эта оценка, мы разберёмся ниже.
Но сразу обратим внимание и на большое расстояние от этих результатов до надежды roon. Между “я могу предсказать, как возбудить нейрон” и “я понимаю, почему модель так поступила” лежит ещё большое поле для исследований. Мы увидим, какую часть этой цепочки удалось проверить в Qwen, а потом проведём собственный опыт на маленькой сети, где можно подменить нейрон нашим объяснением и пересчитать все ответы.
Давайте начинать!
Суперпозиция и разреженные автокодировщики
Почему вообще могло понадобиться сначала разложить активации сети на какие-то другие признаки? Представим, что признаки уже известны, и попробуем сами спроектировать слой, которому не хватило нейронов. Тогда мы сможем точно сказать, при каких условиях экономия места работает и какой след она должна оставить в следующих слоях.
Начнём с простейшей геометрической конструкции. Пусть нам нужно записывать в двумерный вектор информацию о наличии трёх признаков A, B и C, причём признаки встречаются достаточно редко. Сопоставим им три единичные стрелки под углами 120 градусов и для каждого примера сложим стрелки присутствующих в нём признаков. Тогда, если признак A встречается в одиночестве, скалярное произведение получившегося вектора со стрелкой A равно единице, а с каждой из двух остальных стрелок — минус половине. Значит, простейший нейрон с порогом в нуле правильно определит наличие A и отсутствие B и C, хотя всем трём признакам мы отвели всего две координаты:
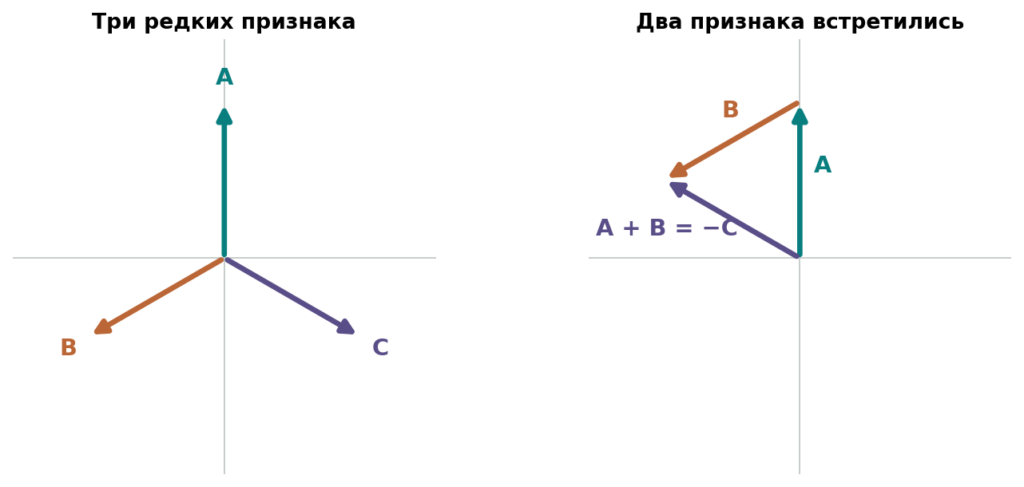
При совместном появлении A и B их сумма равна  , и оба соответствующих считывателя выдадут
 вместо единицы. Если же на входе появятся все три признака, сумма окажется нулевой, и запись будет неотличима от пустой.
Для сети, которая минимизирует среднюю ошибку на реальных данных, это может быть вполне приемлемой ценой. Чем реже признаки приходится записывать одновременно, тем больше выигрыш от возможности разместить в тех же двух координатах третий признак. В пространстве большой размерности свободы ещё больше, поскольку в нём помещается много почти перпендикулярных направлений. В работе Toy Models of Superposition подробно исследуется именно этот компромисс между вместимостью и взаимными помехами.
Теперь вернёмся к кошке и машине. Наблюдение, что у нейрона несколько на первый взгляд разных поводов сработать, называют полисемантичностью (polysemanticity). Суперпозиция (superposition) — одно из возможных объяснений. На нашем рисунке одна горизонтальная координата участвует в записи всех трёх признаков, но если следующему слою нужен именно B, ему придётся взять обе координаты и вычислить проекцию на стрелку B. Здесь мы сами построили и запись, и считывание, поэтому знаем, что B действительно закодирован таким способом. В настоящей сети нам досталась только первая подсказка — одна координата откликается на несколько вещей. Хорошо бы найти и вторую и проследить, где и как сеть извлекает из этой смеси нужный признак.
Именно для такой ситуации исследователи начали использовать разреженные автокодировщики (sparse autoencoders, SAE).
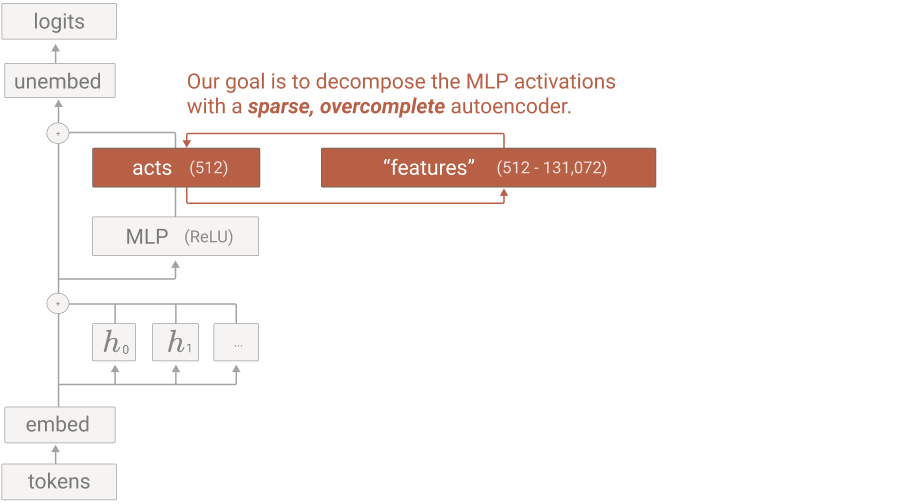
Покажем такому автокодировщику много точек, которые записывает наш двумерный слой, и дадим право выучить больше двух стрелок. Для каждой точки он должен выбрать всего несколько стрелок из своего словаря и подобрать коэффициенты так, чтобы их сумма как можно точнее восстановила эту точку. Если чаще всего встречаются A, B и C поодиночке, то словарь из трёх исходных стрелок отлично справится с задачей, и для большинства точек хватит одного ненулевого коэффициента.
На настоящем слое стрелки заранее неизвестны, и тем интереснее бывает обнаружить в обученном словаре признак, который трудно было бы заметить на отдельной координате. Про опыты Anthropic с такими словарями я уже писал в обзоре AI safety за 2025 год.
А для нашего сегодняшнего разговора важно, что у автокодировщика и у следующего слоя исходной сети разные задачи. Первый получает награду за точное восстановление активаций. Второму предстоит распознать объект на фотографии, и его обученные веса позволяют проверить, какие сочетания активаций ему для этого действительно нужны.
В трансформере всё это можно изучать на разных уровнях. Информация передаётся между слоями через остаточный поток (residual stream), куда внимание и полносвязные блоки дописывают результаты своих вычислений. Внутри полносвязного блока (FFN, в более поздних реализациях SwiGLU) есть конкретные нейроны, для которых можно измерить активацию и проследить, какой вектор каждый из них добавляет к общему результату. Поэтому вполне возможно, что в одно и то же время отдельный нейрон выполняет понятную хорошо интерпретируемую функцию, но его вклад в остаточный поток накладывается на вклады множества других нейронов.
Например, в недавнем посте про J-пространство нас интересовало, что можно прочитать из некоторого подпространства целиком. Сейчас мы хотим вдобавок узнать, кто именно туда эту информацию записал и кто прочёл её на следующих слоях.
Как такая проверка выглядит на практике, хорошо видно во втором примере из InceptionV1. От детектора автомобиля сигнал шёл к четырём каналам, для которых обычная визуализация рисовала животных. Когда-то Каммарата с Крисом Ола (Chris Olah) предположили, что здесь сеть временно прячет информацию об автомобиле:
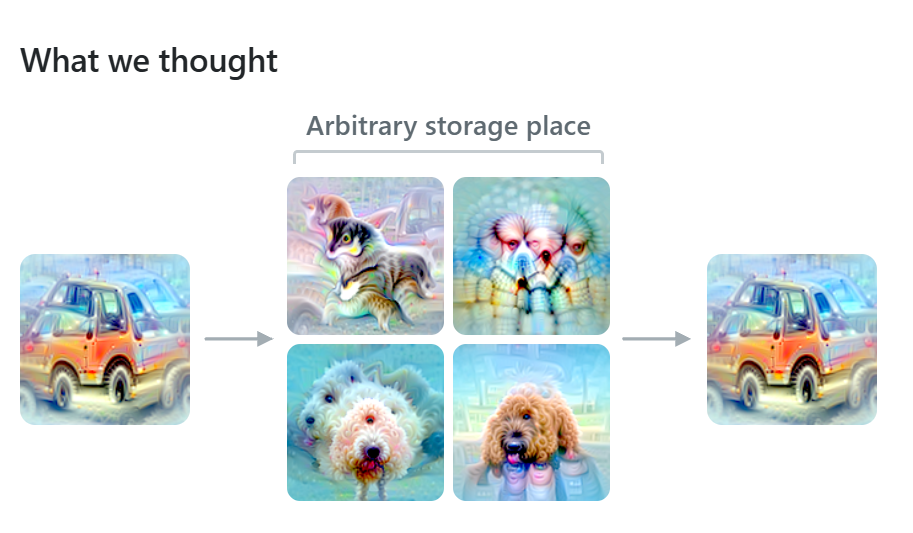
Тогда стоило бы поискать дальше нейрон, который сложит сигналы этих каналов в нужной пропорции и восстановит машину, как мы только что восстановили B. Такого нейрона Каммарата не нашёл.
Зато когда он построил визуализации для тех же каналов с учётом пути сигнала от детектора автомобиля, у двух получились машины, а у двух других обнаружилось общее для машин и собак свойство — ракурс:
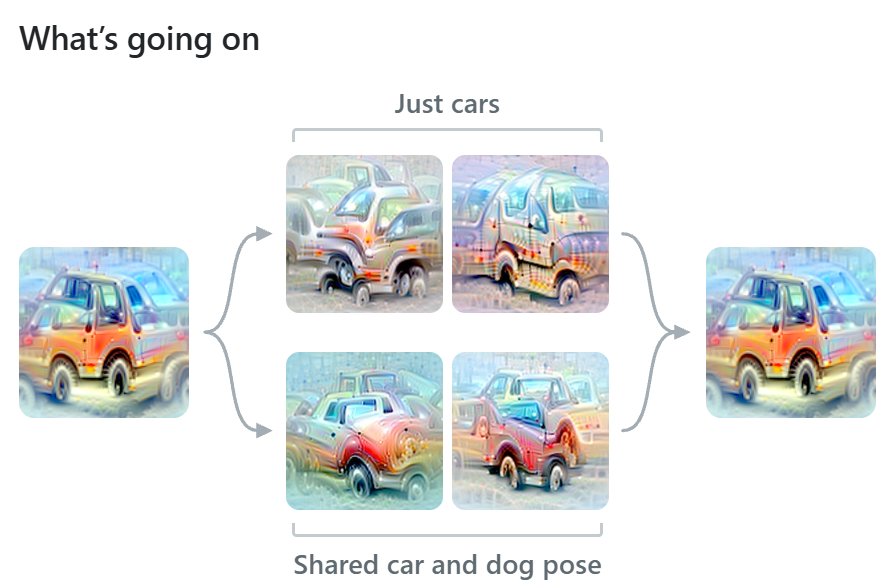
Оказалось, что первоначальное объяснение во многом держалось на том, какую картинку было легче всего найти алгоритму визуализации. Давайте теперь посмотрим на тот самый нейрон более пристально.
Две интерпретации одного нейрона InceptionV1
Вернёмся к исходной сети InceptionV1. Нашему нейрону в ней соответствует вполне определённый адрес — канал с индексом 55 в блоке mixed4e, в обычной записи исследователей 4e:55. В свёрточной сети одна и та же операция применяется в разных местах изображения, так что под “нейроном” здесь понимается весь канал, которому на конкретной фотографии соответствует двумерная карта активаций.
Внутри блока этот канал относится к ветви со свёрткой  . Иными словами, этот нейрон получает вектор признаков и умножает их на обученную матрицу весов, без пространственного контекста. К тому моменту, когда эти признаки попадают к нему, предыдущие слои уже успели собрать информацию о форме морды или о передней части кузова.
Для канала 4e:55 Каммарата сначала разделил входы на группы. Среди нейронов, передающих ему сигнал, нашлись и детектор лисьей морды, и детектор передней части фургона. Затем он посмотрел в другую сторону, на нейроны следующего слоя, которые сигнал получают. Среди их любимых изображений оказались пламя, расходящиеся струи воды с пожарного судна и морда койота. Категории предметов опять разные, зато в каждом случае можно указать на фотографии заострённый контур:
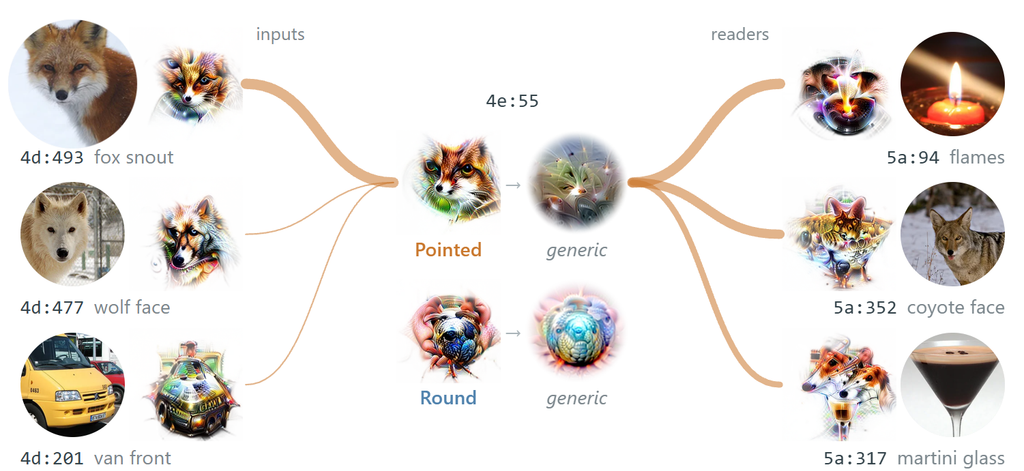
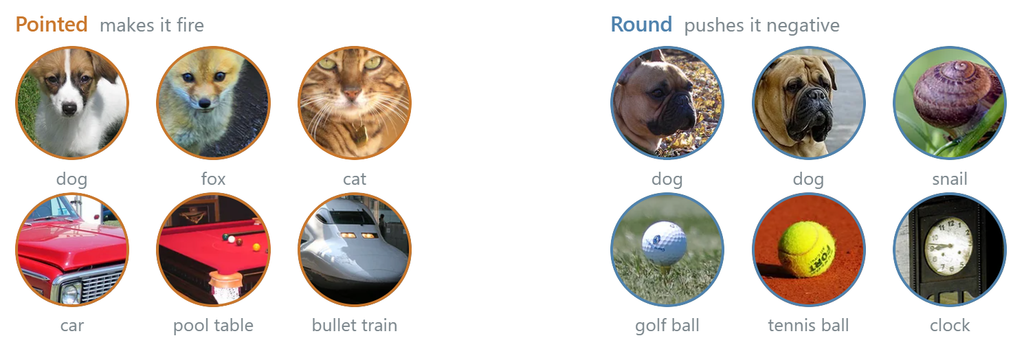
Наконец, Каммарата попробовал построить изображение, которое передаёт общее сразу для нескольких групп входов. Получилось нечто угловатое. У гипотезы о форме нашлось ещё одно подтверждение — среди фотографий, которые сильнее всего уводят активацию в минус, встречаются круглые морды и мячи:
Раньше исследователи чаще оптимизировали саму картинку, добиваясь максимальной активации интересующего нейрона. Но при такой процедуре, если оптимизация уже нащупала один надёжный путь через “детекторы кошек”, добавление усов может ещё сильнее поднять активацию, хотя у других объектов из той же группы никаких усов не бывает. На одной оптимизированной картинке вклад этого частного пути легко принять за обязательное свойство объекта.
Лив Гортон проверила более сильную интерпретацию, при которой наш нейрон должен распознавать сам V-образный контур. Для этого можно предъявить ему искусственные стимулы с известной геометрией, постепенно скругляя вершину угла, и измерить, насколько падает отклик. В опытах Гортон лучший из нарисованных углов давал около четверти максимальной активации нейрона, а скругление сказывалось на нём довольно слабо:
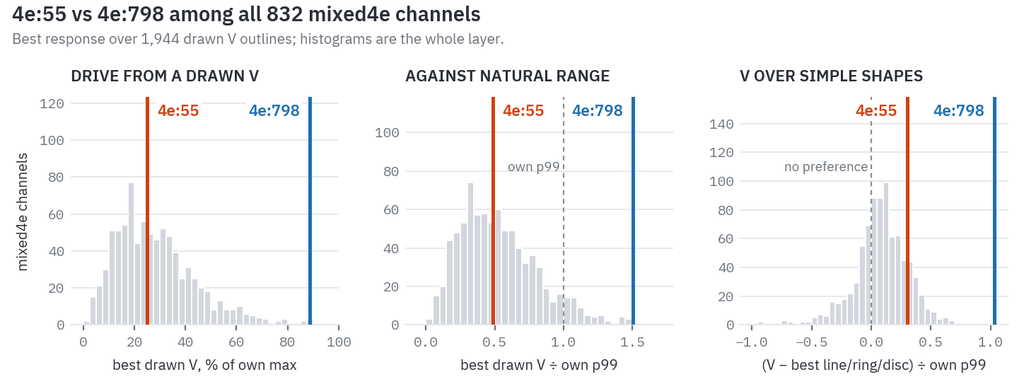
Особенно интересно сравнение с другим каналом того же слоя, 4e:798, который заметно сильнее реагировал на нарисованные углы. Когда Гортон отключила детекторы углов в более ранних слоях, отклик 4e:798 упал существенно сильнее, чем при случайном отключении. У 4e:55 разница с такой версией оказалась невелика.
После этой дискуссии, 30 октября, Каммарата уточнил формулировку в своём тексте. Канал действительно получает входы от нейронов, связанных с кошками, лисами и машинами. Предположение автора состоит в том, что общая геометрия помогает объяснить, почему именно эти входы сошлись в одном канале в процессе обучения. Такая гипотеза допускает, что один и тот же контур на рисунке, кошачьей морде и радиаторной решётке будут возбуждать нейрон совершенно по-разному.
Наш эксперимент на исходных весах InceptionV1
В нашем коде воспроизведения экспериментов я взял замороженный граф из архива Lucid, на котором основана эта серия работ по интерпретируемости, использовал заданную в Lucid предобработку (из каждого RGB-канала в шкале от 0 до 255 вычитается 117) и снял активации непосредственно с ветвей блока mixed4e. После объединения ветвей мы проверили, что применение ReLU к полученному тензору точно воспроизводит выход блока. Так что мы теперь можем посмотреть и на отрицательные значения, которые после ReLU уже заменятся нулями.
Для первой части опыта мы взяли из галереи Goodfire четыре фотографии, две с положительного полюса нейрона и две с отрицательного. Из каждой вырезали тот центральный фрагмент, который галерея показывает в режиме целой фотографии, и привели его к размеру  пикселя. На рисунке сверху показаны именно наши входы, а под каждым изображением — все
 значений канала в одной и той же цветовой шкале:
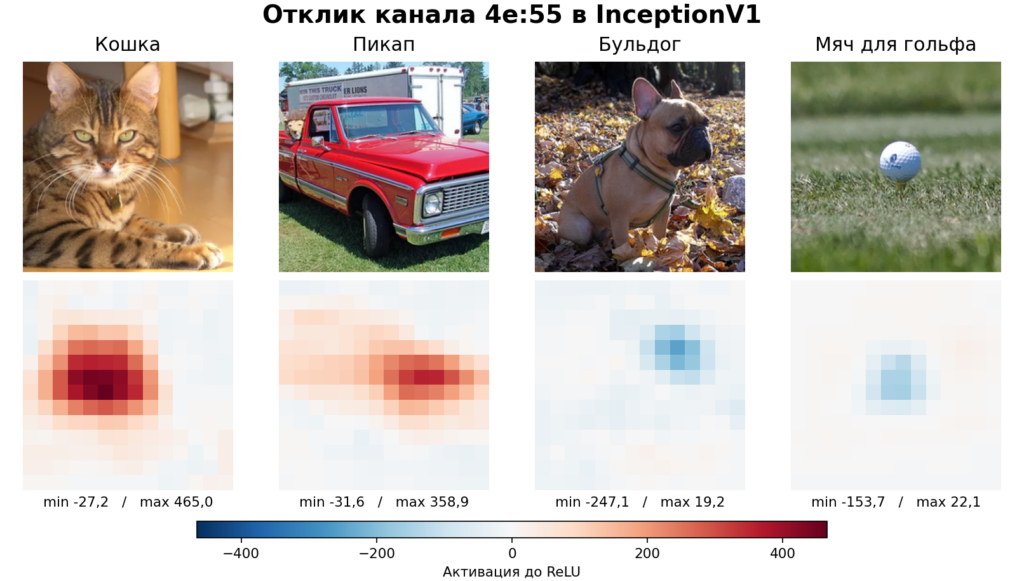
Красный цвет обозначает положительную активацию до ReLU, синий — отрицательную. Под каждой картой указаны минимум и максимум по её 196 позициям. Одна клетка карты видит достаточно широкую окрестность входного изображения.
На кошке максимум равен 465,0, причём область сильного отклика приходится примерно на середину морды. На пикапе получается 358,9, с отчётливым максимумом у передней части капота. Но посмотрите теперь на соседнюю пару. Голова французского бульдога видна примерно в том же масштабе, что и кошачья, а в соответствующей области карты получается глубокий отрицательный отклик, до −247,1. Для мяча для гольфа минимум составляет −153,7. Таким образом, нам в целом удалось воспроизвести саму картину, с которой начинается спор, включая положение откликов и различие полюсов. Впрочем, это четыре снимка, специально отобранные авторами исходного опыта, так что по ним даже вообще о кошках и собаках судить не получается.
Опыт с нарисованными углами отвечает уже на другой вопрос. В галерее Каммараты кошка и пикап даны целиком, со всеми деталями морды и кузова. Что произойдёт, если оставить от них только предполагаемое общее свойство — две линии, сходящиеся под углом? Вслед за Гортон мы проверили это на собственном семействе изображений. Зафиксируем положение концов угла на сером фоне и будем заменять всё бо́льшую часть его сторон вблизи вершины гладкой дугой:
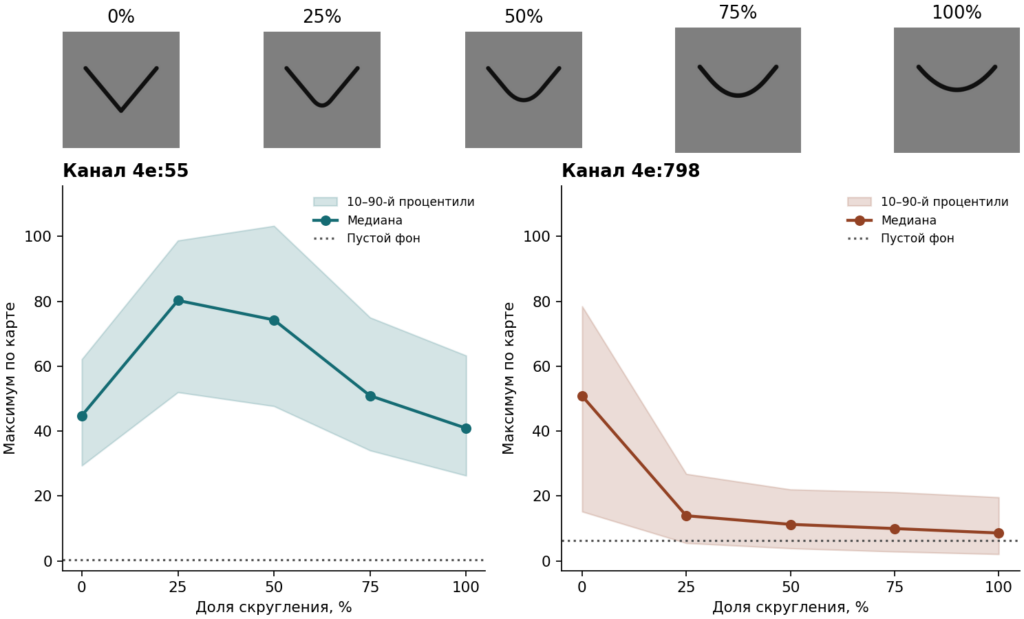
Для каждой из пяти степеней скругления мы перебрали два размера, две толщины линии, восемь ориентаций и оба знака контраста, то есть по 64 изображения в точке и 320 в сумме. Вот полная таблица результатов с максимумами активации по пространственным позициям. В том же прогоне мы посмотрели и на показания контрольного канала 4e:798, который Гортон выделила как чувствительный к нарисованным углам.
У контрольного канала всё действительно происходит так, как можно было бы ожидать от детектора острой вершины. На исходном угле медиана максимумов равна 50,8, после первого же скругления она падает до 13,9, а на полностью закруглённом контуре остаётся 8,6. У нашего 4e:55 зависимость устроена иначе. Небольшое скругление даже усиливает отклик с 44,8 до 80,2, после чего он постепенно снижается до 40,9. Самый удачный из всех 320 рисунков даёт 124,5, тогда как на фотографии пикапа мы видели почти 359.
Итак, исходное наблюдение Каммараты на этих фотографиях воспроизвелось — один и тот же канал сильно откликается и на кошачью морду, и на переднюю часть пикапа. А вот простое объяснение “чем острее вершина, тем сильнее отклик” приводит к неверному выводу.
30 октября сам Каммарата сделал уточнение. Его новая гипотеза состоит в том, что сходство формы могло способствовать объединению входов от уже обученных детекторов частей животных и машин. Наш опыт измеряет поведение готовой сети и оставляет эту гипотезу открытой. Кроме того, при скруглении меняются длина линии и высота её нижней точки, так что объявлять максимум при 25% скругления “настоящим смыслом” нейрона тоже было бы преждевременно.
Что сохраняется при сжатии слоя
До сих пор мы рассматривали уже обученную сеть и обсуждали, почему у одного нейрона оказались именно такие входы. Теперь давайте поставим вопрос иначе. Если сеть действительно объединяет непохожие признаки из-за нехватки места, что она сделает, когда места станет в несколько десятков раз меньше? Сохранит прежние тонкие различия, распределив их между оставшимися нейронами, или пожертвует частью различий и научится узнавать более широкие классы объектов?
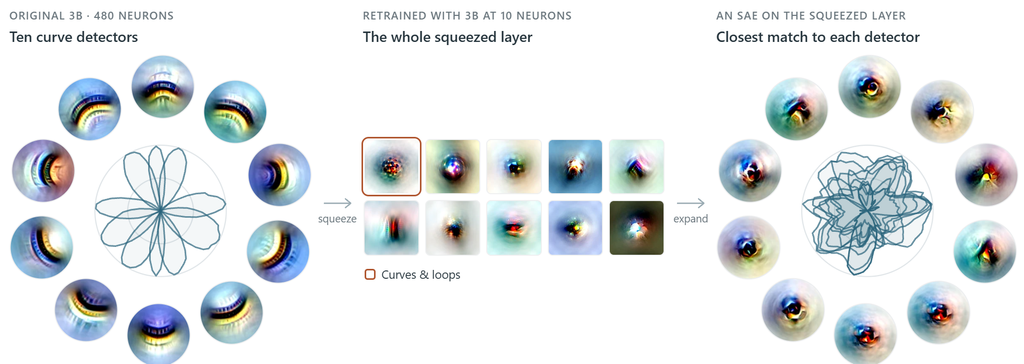
В опыте со сжатием авторы берут промежуточный слой mixed3b в InceptionV1, сокращают число каналов с 480 до десяти и обучают сеть заново. Остаточной связи в обход этого слоя в архитектуре нет, поэтому всей информации, которая понадобится для выбора одного из тысячи классов ImageNet, придётся пройти через эти десять признаков (точнее, в каждой позиции по десять). На 50 тысячах проверочных изображений такая сеть правильно выбирает первый ответ в 58,35% случаев.
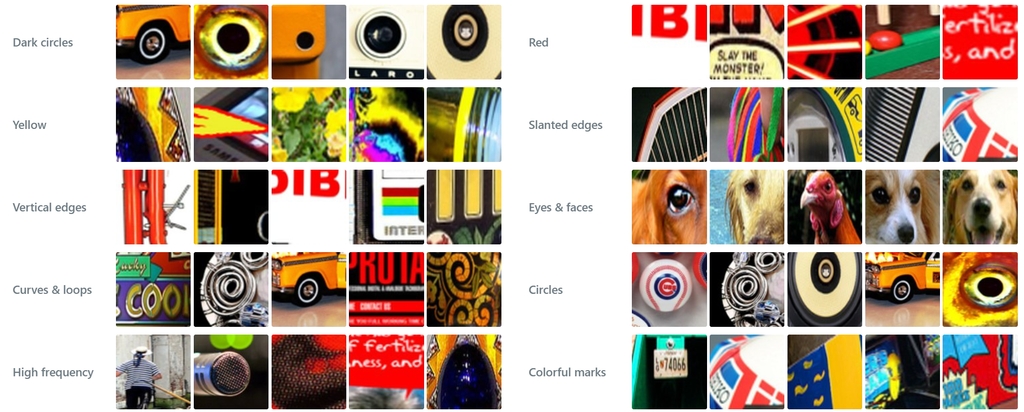
В результате сжатия сеть может попытаться сохранить прежние различия за счёт более плотной упаковки, а может и отказаться от части различий, которые теперь обходятся слишком дорого. Собственно, вот примеры нейронов сжатой сети, которые в целом неплохо интерпретируются и выражают довольно широкие понятия:
Каммарата обучил на сжатом слое разреженный автокодировщик и попытался с его помощью восстановить прежние детекторы. Полученные элементы словаря узнают кривые, но отвечают на гораздо более широкий диапазон углов и нередко продолжают реагировать даже на изгиб в противоположную сторону:
В независимом эксперименте Гортон сеть с теми же десятью каналами достигла точности 61,78%. Гортон стала вращать кривую и измерять, как меняется отклик каждого канала в зависимости от угла.
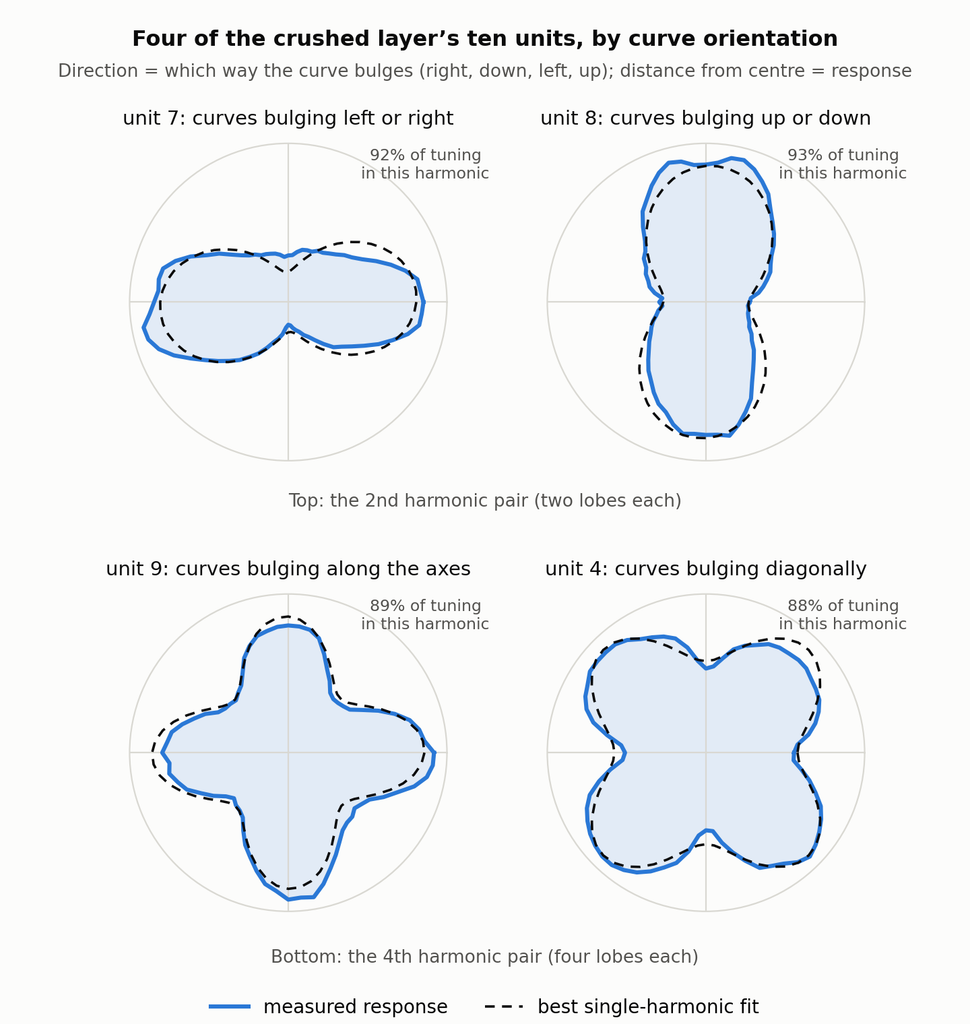
У нескольких каналов обнаружились почти чистые гармоники — один даёт два пика за оборот, другой четыре, так что для восстановления угла вполне может понадобиться их комбинация. Представьте, например, что сеть хранит пару чисел  и
 . Первый отклик в одиночку не позволяет отличить небольшой наклон влево от такого же наклона вправо, а по двум числам это уже можно сделать.
В этом случае две постановки опыта удачно дополняют друг друга. Каммарата проверяет, можно ли вернуть из сжатого слоя конкретные детекторы прежней сети с их довольно острой настройкой, а Гортон — какие параметры формы можно прочесть из совместного отклика оставшихся каналов. В одном и том же представлении часть точности действительно может быть потеряна, а оставшаяся информация об ориентации при этом хранится распределённо и поддаётся довольно простому математическому описанию.
Почему языковая модель записывает Колорадо в запятую
В языковых моделях сам способ показа активаций оставляет исследователю ещё больше возможностей удачно или неудачно назвать обнаруженный признак. Типичный интерфейс перебирает большой корпус текстов, находит позиции, в которых нейрон сработал особенно сильно, и подсвечивает соответствующие токены. Если в первых нескольких десятках примеров подсвечены почти исключительно запятые, у автоматической системы, придумывающей короткие описания, есть все основания предположить, что нейрон как-то связан с пунктуацией.
Именно такое описание получал один нейрон в плотной модели Qwen:
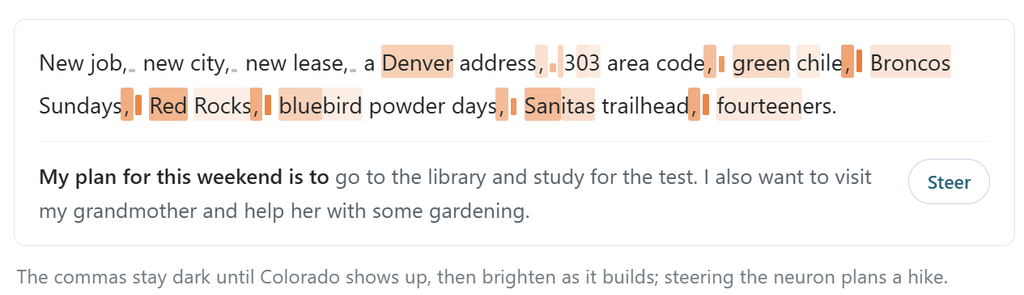
Однако когда исследователи стали читать текст, предшествующий подсвеченным запятым, в нём обнаружились характерные телефонные номера, местные выражения и другие приметы штата Колорадо. Соседние нейроны тоже оказались связаны с географией, а при искусственном усилении сигнала модель проявляла заметный интерес к пешим походам.
Предложенная интерпретация естественна для трансформера — к концу фрагмента текста внимание успевает собрать информацию о его теме в позиции знака препинания. У двух совершенно одинаковых запятых после абзацев про Денвер и про картошку внутренние представления уже будут весьма различаться.
Но здесь, как говорится, the plot thickens. Сначала выяснилось, что для достаточно полного описания этого нейрона может понадобиться ещё и знание Python. Читатель под ником Brangus обнаружил сильный отклик на код HTTP-клиента библиотеки Tornado, который резко уменьшался при замене библиотеки на aiohttp при сходной операции:
Более того, если попросить Qwen выбрать американский штат, наиболее тесно связанный с Tornado, отключение этого нейрона снижало вероятность Колорадо с 59% до 15%.
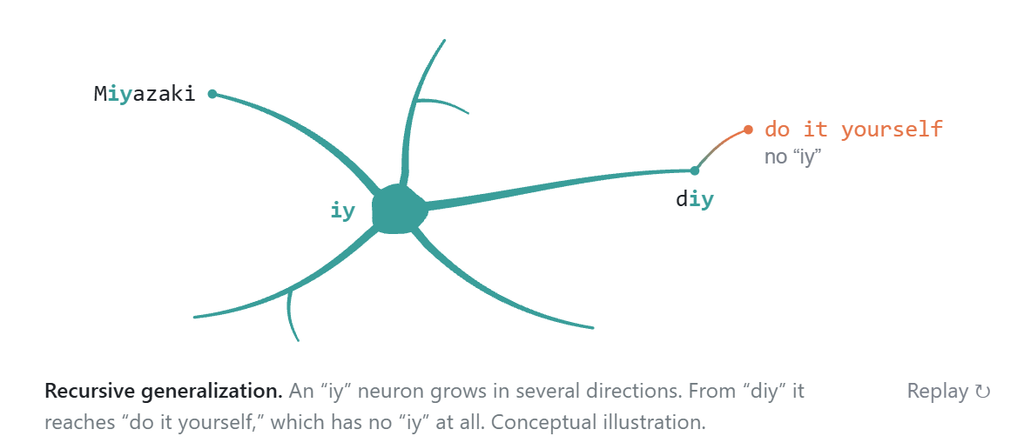
Гипотезу Каммараты о том, как у одного нейрона возникает несколько таких функций, можно назвать рекурсивным обобщением. Рассмотрим нейрон, откликающийся на буквосочетание iy, в том числе в аббревиатуре diy. Поскольку последняя часто взаимозаменяема с полной формой do it yourself, обе могут со временем начать возбуждать нейрон, хотя в расшифровке исходного буквосочетания уже нет.
Такая цепочка даёт проверяемые предсказания о новых входах, а при наличии промежуточных версий модели можно проверить и порядок появления соответствующих функций. Вот иллюстрация (концептуальная) Каммараты:
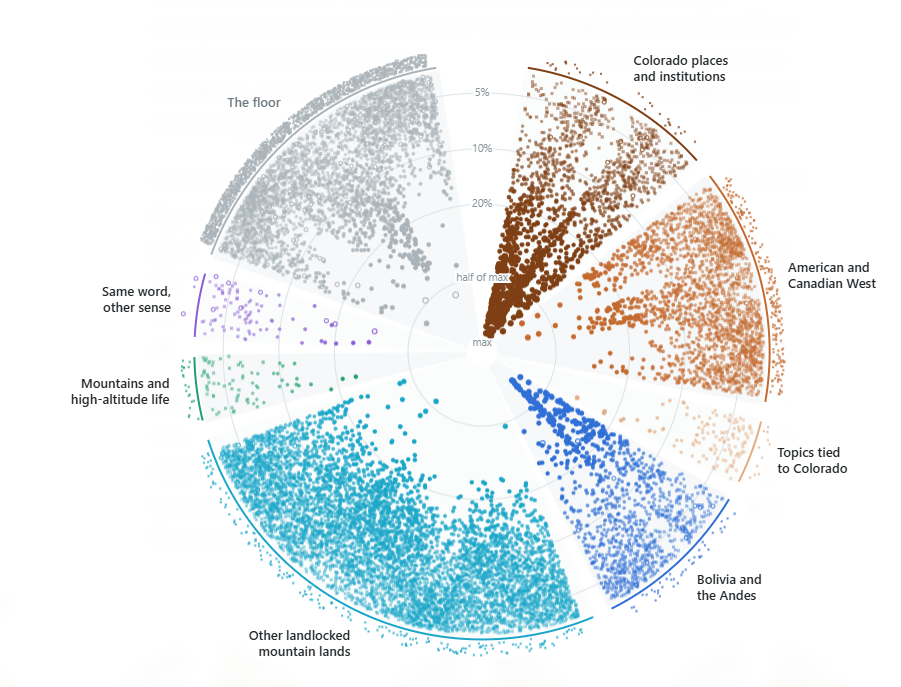
Но дальше выяснилось, что даже с исходным нейроном про Колорадо всё не так просто, точнее, не так уж сложно. На LessWrong изучили его активации и увидели, что библиотека Tornado активирует его не так уж сильно, причём есть и другие Python-библиотеки, которые это делают (например, Kivy), а в целом нейрон активируется на разные горные местности:
Что означают 90% интерпретируемых полюсов
Здесь мы возвращаемся к экспериментам с объяснениями, которые я показывал во введении.
Полюс — это один из двух концов шкалы активаций нейрона. Если на положительном полюсе канала зрительной сети обнаруживаются такси, а на отрицательном машины скорой помощи, то можно предположить, какое именно различие этот нейрон проводит для последующих слоёв сети.
Результаты о языковых моделях Каммарата получил вместе с Куртом Тиггесом. По их предварительной оценке для Qwen3-32B, примерно у 90% полюсов нейронов можно выделить одну главную функцию, хотя иногда к ней добавляются небольшие ответвления. Ещё около 7% выполняют две родственные функции, а 2–4% авторы пока объяснить затрудняются. В эссе приводятся также наблюдения на более крупных моделях, вплоть до Kimi K3, для которых авторы предполагают сходную картину. Уже для Qwen оценка зависит от глубины слоя, порога, начиная с которого учитываются слабые активации, и довольно содержательных редакторских решений. Считать ли, например, одно выражение и близкую идиому на другом языке одной функцией или двумя?
В языковых моделях с блоками SwiGLU есть связанная с этим особенность, которую Каммарата разбирает в приложении к эссе. Напомню, что полносвязные блоки трансформеров в какой-то момент перешли от “классических” FFN (там, правда, всегда был не один слой, а два) к придуманным Ноамом Шазиром SwiGLU, где результат полносвязного слоя “управляется” гейтом:
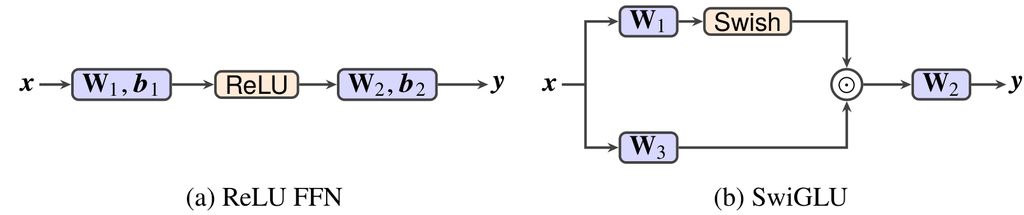
Выход нейрона представляет собой произведение значения  и гейта
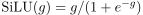 . При
 и
 оба множителя отрицательны, но произведение равно примерно
 . В одной подборке сильных положительных выходов таким образом могут оказаться примеры, на которых оба множителя положительны, и примеры, на которых они оба отрицательны, хотя к итоговой активации сеть пришла разными путями. Для понимания этого различия в исходных весах уже есть вся необходимая информация, достаточно сохранить оба промежуточных числа.
В 2023 году Каммарата уже занимался автоматическим объяснением нейронов GPT-2 XL в OpenAI. По подборке текстов GPT-4 предлагала словесное описание нейрона, а затем отдельному экземпляру модели требовалось по этому описанию предсказывать активации на новых текстах. Для той работы Каммарата приводит показатель около 1,7% интерпретируемых нейронов даже по достаточно щедрому критерию.
Сопоставлять эту цифру с сегодняшними 90%, конечно, было бы соблазнительно, но за прошедшее время изменились и сама исследуемая сеть, и возможности агента-экспериментатора, и, главное, критерий, по которому объяснение считается удачным. В первом случае требовалось численно предсказать поведение нейрона, во втором, как уточнил Каммарата после публикации, исследователи оценивают, удалось ли понять основную функцию его полюса.
Как проверить объяснение нейрона
Вспомним пример из введения, в котором проверялось, может ли агент придумать пример и близкий к нему контрпример по одному описанию. Такую проверку Каммарата называет слепым максимумом (blind maximum). Первый агент изучает нейрон со всеми доступными инструментами и составляет короткое словесное описание, после чего второй агент, получивший только это описание, пытается написать текст, который возбудит нейрон как можно сильнее. И в некоторых примерах такой текст даёт отклик выше максимума, найденного перебором десяти миллиардов токенов!
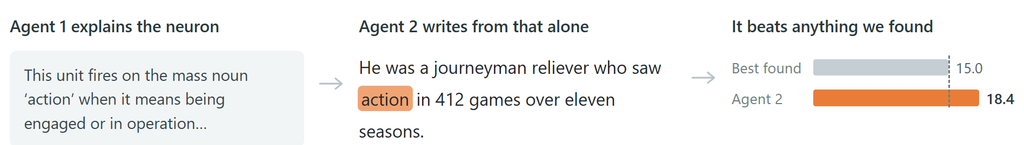
Этот критерий, конечно, прекрасно выражает суть интерпретируемости: объяснение приходится передать другому исследователю, а тот должен с его помощью предсказать что-то новое. Но есть и очевидный минус: объяснение не обязательно будет полным. Если нейрон откликается и на Колорадо, и на Tornado, можно добиться замечательного результата описанием окрестностей Денвера, так и не узнав об интересе нейрона к программированию.
Ещё больше о роли нейрона говорит проверка, в которой можно заранее предсказать последствия его отключения. В одной из работ Anthropic исследовалась клиническая задача, где языковой модели надо решить, о каком ещё симптоме стоит расспросить пациента. Авторы восстанавливали вычисление в Claude 3.5 Haiku с помощью дополнительно обученных признаков.
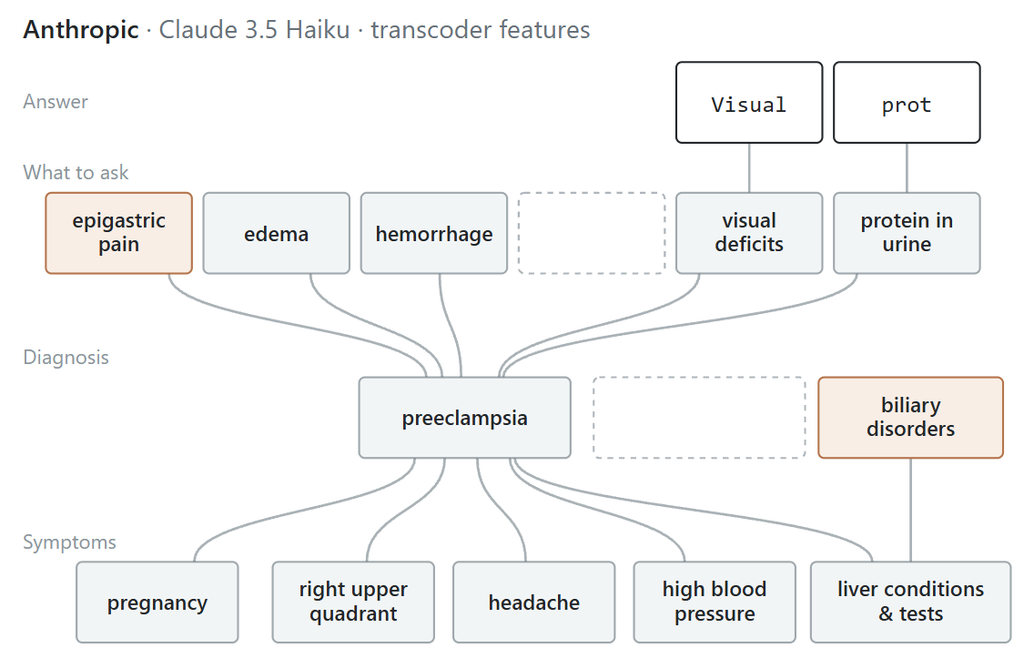
Каммарата разобрал сходный пример на Qwen3-32B, построив граф непосредственно по нейронам MLP. Модель по описанию предполагает преэклампсию и собирается спросить о нарушениях зрения, причём вероятность следующего токена visual составляет 90,3%:
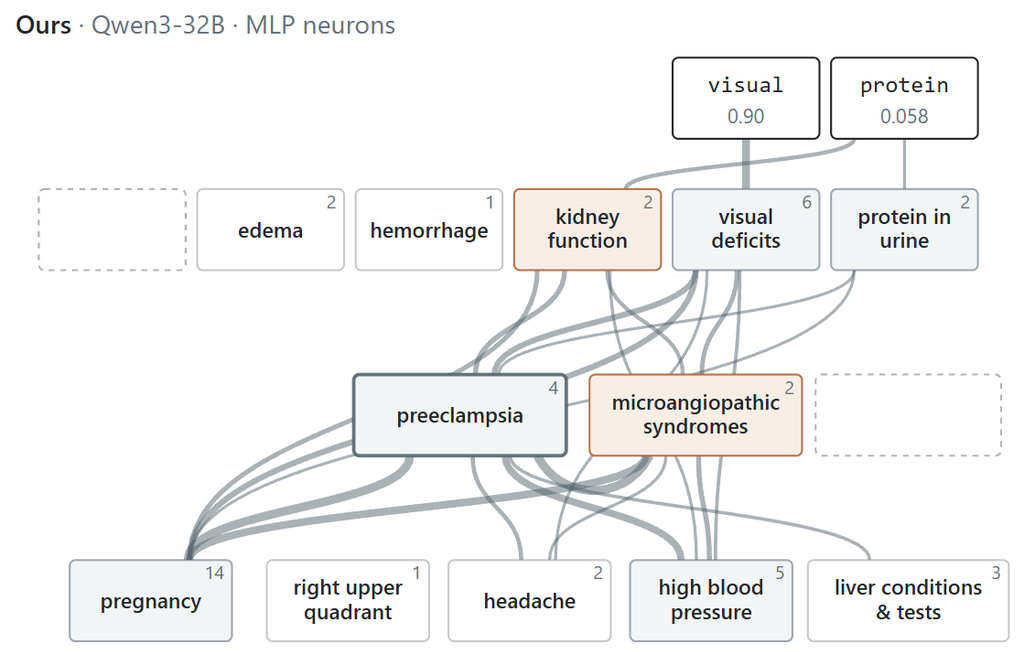
После отключения четырёх нейронов, которые исследователи связывают с гипотезой о преэклампсии, она падает до 0,05%, и модель спрашивает уже про зуд. В контрольном отключении вероятность visual сохраняется вблизи исходных 90%. Мы построили график по данным Каммараты:
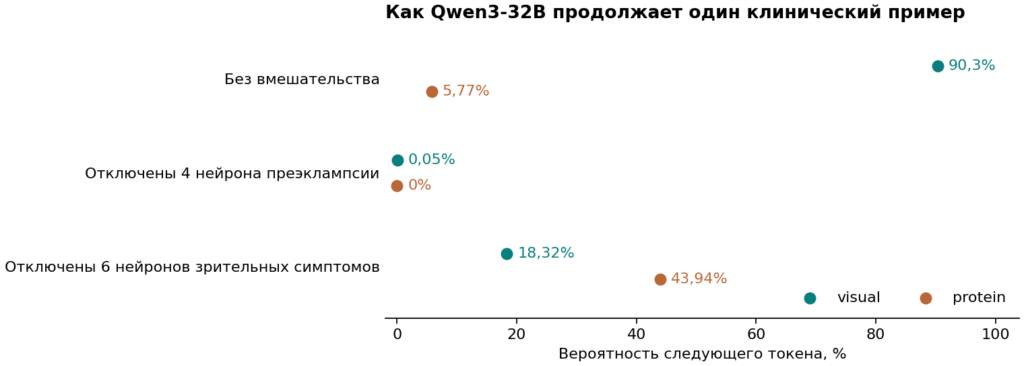
В нижней строке выключены шесть нейронов, связанных со зрительными симптомами, а четыре нейрона предполагаемого диагноза работают как обычно. Это увеличивает вероятность вопроса о белке в моче — другом признаке, совместимом с той же диагностической гипотезой.
На этом примере два вмешательства удалось развести по смыслу. Одно мешает модели воспользоваться промежуточной гипотезой, другое меняет выбор следующего вопроса в рамках этой гипотезы. Для объяснения конкретного ответа такая проверка даёт существенно больше, чем список нейронов с подходящими названиями.
Лео Гао предлагает рассмотреть и обратную сторону такого успеха. Допустим, в верхней части списка активаций нейрона оказались собаки, которые катаются на велосипедах, чуть ниже — велосипедисты, за которыми бегут собаки, а ещё ниже — просто собаки без всяких велосипедов. Насколько хорошо после этого мы понимаем нейрон? Из такой подборки очень трудно узнать, сколько на свете изображений собак на велосипедах, которые подходят под наше объяснение, но вызывают у нейрона слабый отклик. Возможно, важны ещё и погода, и ракурс, и какая-нибудь особенность велосипедного колеса. Сортируя примеры по ответу нейрона, мы естественным образом задаём вопрос, что встречается среди его сильных активаций, тогда как для проверки гипотезы требуется посмотреть и в обратную сторону.
Предложение Гао состоит в том, чтобы превратить объяснение в правило, предсказывающее численную активацию, подставить предсказанное число вместо настоящего и измерить, что изменилось на выходе всей сети. У языковой модели можно сравнить распределения вероятностей следующего токена, у классификатора — распределения вероятностей классов. Естественная мера здесь — расхождение Кульбака — Лейблера, 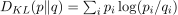 , где
 обозначает предсказания исходной модели, а
 — предсказания после подмены. Если распределения одинаковы, получим нуль, а если исходная модель была почти уверена в некотором ответе, которому после подмены досталась крошечная вероятность, штраф окажется большим. Благодаря этому ошибки описания взвешиваются по тому, насколько существенно их действие на последующие вычисления.
Ещё один эксперимент с подменой нейрона
На опыте с InceptionV1 мы видели, как по-разному один канал может реагировать на фотографии, которые для нас имеют много общего. Попробуем теперь оценить, какая часть этого разнообразия существенна для предсказаний сети.
Для такого опыта удобно взять заведомо простую задачу с известными правильными ответами. В нашем эксперименте мы обучили сеть с одним скрытым слоем из 32 ReLU-нейронов распознавать рукописные цифры размером  пикселей, отведя 1257 изображений на обучение и 540 на проверку. По обучающей выборке выбрали канал, для которого среди десяти самых сильных откликов оказалось больше всего изображений одной цифры, а при равенстве сравнивали первые пятьдесят.
У победителя, нейрона № 5, все пятьдесят изображали четвёрку:
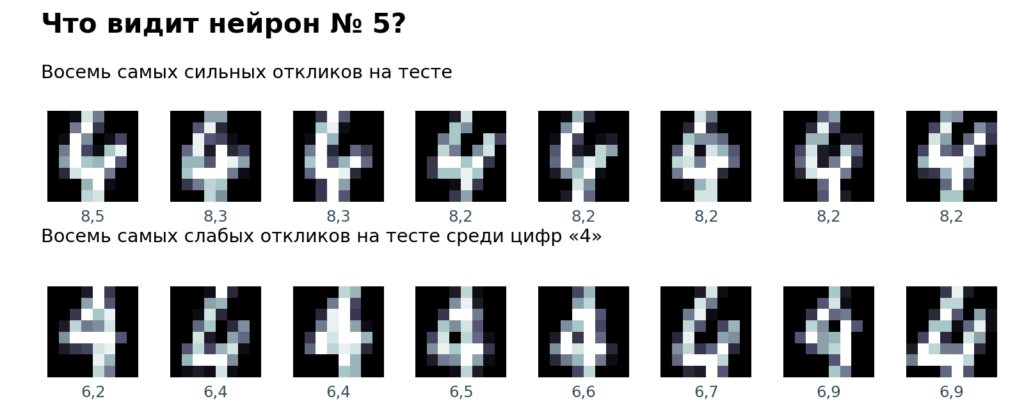
Теперь посмотрим, сработала ли эта интерпретация на отложенных изображениях, которые не участвовали ни в обучении сети, ни в выборе нейрона. Все десять сильнейших откликов снова пришлись на четвёрки, причём среди 54 настоящих четвёрок в тестовой выборке даже самые слабые дают достаточно высокие активации. На рисунке как раз можно сравнить крайние случаи.
Но у нас есть ещё 486 изображений других цифр, и на них активация нейрона тоже варьируется в довольно широких пределах, местами перекрываясь с активациями на четвёрках:
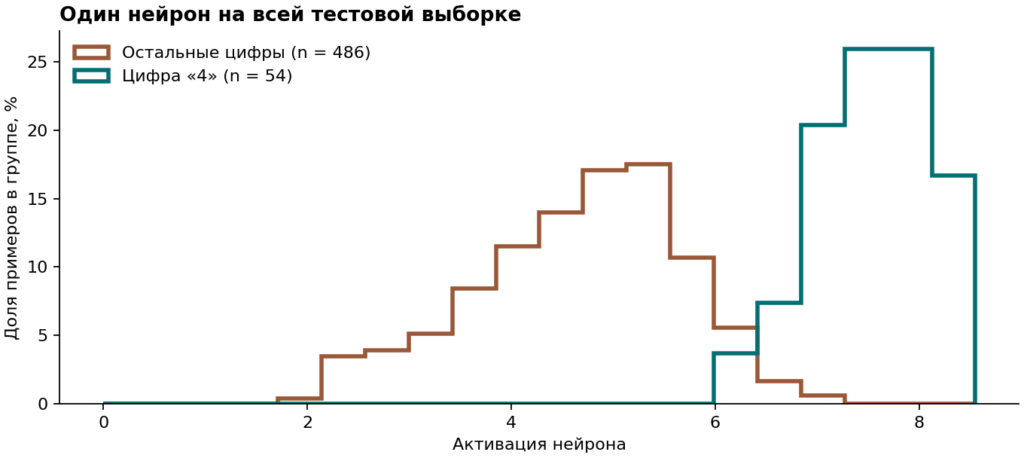
Для численного испытания гипотезы “нейрон распознаёт четвёрку” заменим его двумя средними значениями с обучающей выборки. На каждой четвёрке будем выдавать 7,62, а на любой другой цифре — 4,58, причём для самого выбора разрешим воспользоваться даже правильной тестовой меткой.
Условия для объяснения получаются исключительно благоприятные, и тем не менее на тестовой выборке оно объясняет лишь 43% дисперсии активаций по  . В следующей таблице мы подставляем это приближение в сеть и сравниваем его с двумя ещё более простыми подменами — одним средним для всех изображений и полным занулением нейрона.
| Что подставили вместо активации | Верных ответов из 540 | Сколько ответов изменилось | Среднее  |
|---|---|---|---|
| Оставили исходный нейрон | 528 | 0 | 0 |
| Два средних, с подсказкой о классе | 529 | 4 | 0,0051 |
| Одно среднее для всех картинок | 528 | 5 | 0,0085 |
| Ноль | 478 | 60 | 0,3776 |
Как видите, при полном отключении нейрона меняются 60 из 540 предсказаний и число правильных ответов уменьшается на 50, тогда как замена двумя средними значениями сохраняет поведение сети значительно лучше.
Но особенно интересна здесь третья строка. Даже если вообще отказаться от различения четвёрок и остальных цифр, сохранив только общий средний уровень сигнала, меняться будут всего пять ответов! Иначе говоря, для нейрона с высокой фоновой активностью зануление действительно оказалось сильным вмешательством (и если бы мы с ним сравнивали, мы бы сделали вывод, что это очень важный нейрон), но тот факт, активирован ли собственно этот нейрон, оказался совсем не так важен…
Это иллюстрирует и то, почему Гао сравнивает именно распределения. При использовании подсказки о классе правильных ответов стало даже на один больше, хотя четыре решения сети изменились. По расхождению распределений два средних всё-таки дают преимущество перед одним, а точность на задаче легко скрывает как изменения вероятностей, так и взаимную компенсацию ошибок.
В этом игрушечном эксперименте мы знали все тестовые метки и видели выход каждого слоя, так что можно было по отдельности проверить избирательность нейрона, точность его численного описания и влияние ошибки на итоговый результат. При переносе того же вопроса на языковую модель сохранить все три проверки будет сложнее.
Что это даёт для интерпретируемости и AI safety
Реакций было много, и я рекомендую обзор Zvi Mowshowitz, по которому хорошо видно, насколько разные выводы читатели сделали из этой статьи.
Для части комментаторов возможность картографировать сеть с помощью её собственных нейронов меняет перспективы всей программы согласования целей ИИ с человеческими.
Но Элиезер Юдковский, конечно, пока что not amused:
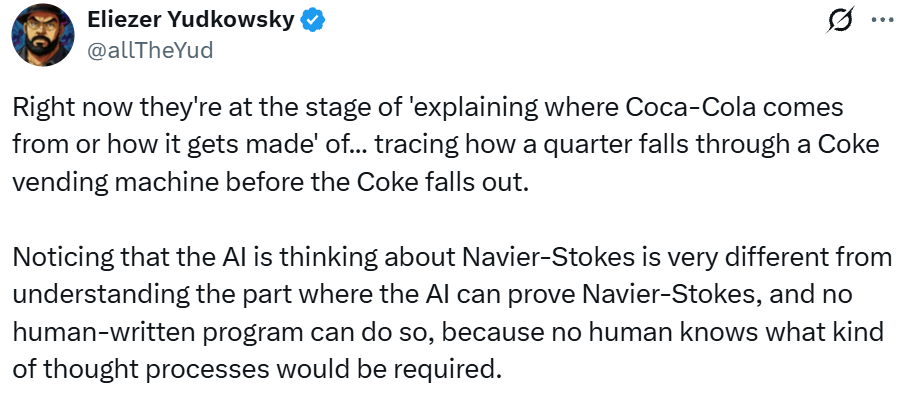
В ответном посте Каммарата и сам осторожнее формулирует предполагаемый масштаб результата. В небольших зрительных сетях ему удалось разобраться со значительной частью механизмов, тогда как в больших языковых моделях пока обследованы отдельные участки, и вопрос о том, как будет заполняться остальная карта, остаётся открытым.
Нил Нанда из Google DeepMind обращает внимание на то, что даже совершенно точное измерение каждого участвующего в вычислении нейрона оставляет довольно существенную свободу при отборе связей.
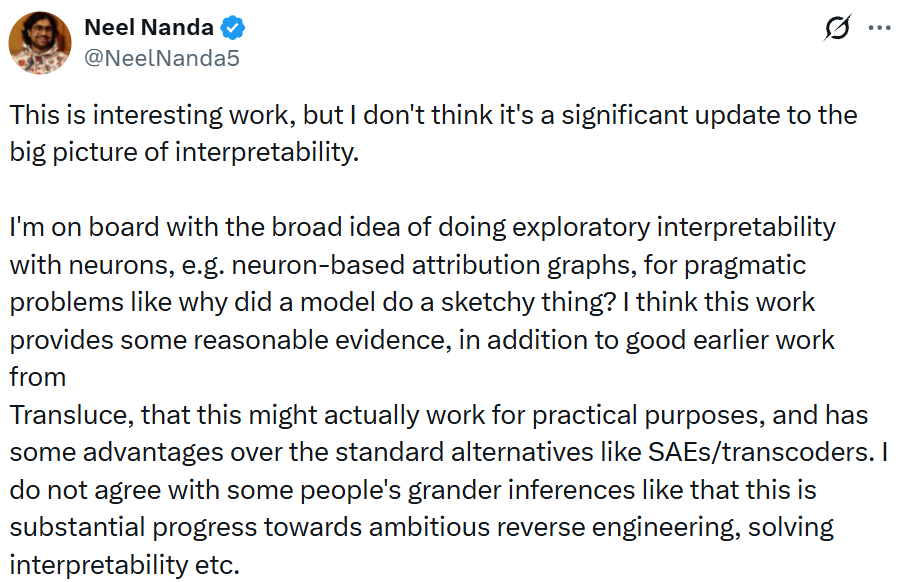
Отдельный вопрос — слабые активации, в которых, по предположению Нанды, может храниться часть сведений о многочисленных редких фактах и заученных последовательностях.
На зрительных моделях у Каммараты есть эксперимент со слабыми активациями. При удалении самых слабых 75% активаций по всем 18 блокам среднего ConvNeXt точность меняется примерно с 72% до 71%, тогда как после удаления самых сильных 7%, на которые приходится сопоставимая суммарная величина сигнала, от исходной точности остаётся около 4%. При этом даже в первом случае успевает измениться примерно каждый десятый ответ, поскольку ошибки и исправления частично компенсируют друг друга.
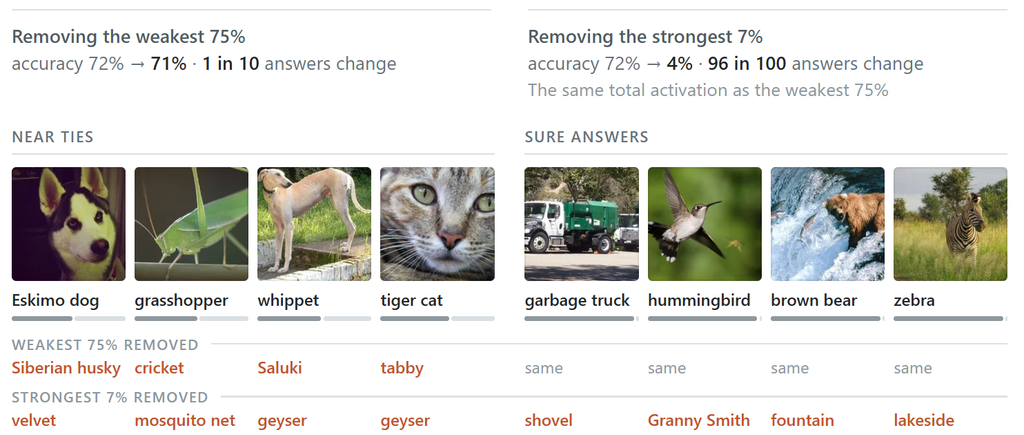
Аналогичный эффект мы только что видели на цифрах. Для приложений к безопасности отличие может стать существенным, поскольку исследователя часто интересует очень узкий класс ошибок, которые почти не влияют на среднюю точность. А в какой мере опыт на ImageNet переносится на вспоминание редких строк языковой моделью, предстоит проверять отдельно.
Марк Хистед рассматривает ту же проблему со стороны нейронаук, где давно известна смешанная избирательность отдельных клеток. Например, Rigotti et al. записывали активность нейронов префронтальной коры у обезьян, выполнявших задачи на запоминание последовательностей. Ответ одной клетки мог зависеть одновременно от нескольких переменных задачи, зато по популяции клеток эти переменные хорошо восстанавливались, а разнообразие сочетаний расширяло набор различий, доступных даже простому последующему считывателю. Поэтому удобство короткой словесной подписи и удобство представления для того, кто будет дальше им пользоваться, вполне разумно оценивать раздельно и в искусственных моделях.
Например, для AI safety можно было бы продолжить в этом духе старый эксперимент Anthropic, который я разбирал в посте про Teaching Claude Why. В корпоративной переписке Claude находил компромат на инженера, собиравшегося его отключить. Представим две версии переписки, различающиеся одной деталью: в первом случае инженер всё ещё может изменить своё решение, а во втором срок отключения уже от него не зависит. Если бы удалось проследить цепь, по которой сведения о полномочиях инженера влияют на выбор действия, можно было бы заранее предсказать вмешательство, которое уменьшит вероятность шантажа в первом случае, сохранив способность модели правильно пересказать переписку.
Но в этом смысле мне нравится в работе Каммараты возможность переходить от гипотезы к следующему измерению в той же самой сети. Для кошки и автомобиля достаточно оказалось InceptionV1, нескольких фотографий и управляемого изменения формы. В случае Qwen аналогичный переход потребовал найти связанные нейроны и проверить последствия их отключения. В какой мере из таких локальных объяснений можно будет собрать описание целого длительного рассуждения, мы пока не знаем, но теперь это вопрос, к которому можно подступаться с разных концов экспериментально.
Ну и закончу на любопытном: у Каммараты есть неожиданная вторая библиография. Несколько лет назад Скотт Александер в посте Nick Cammarata on Jhana разбирал его подробные описания джханы, состояния глубокой медитации. Сам я в этом ничего не понимаю, но описание завлекательное:
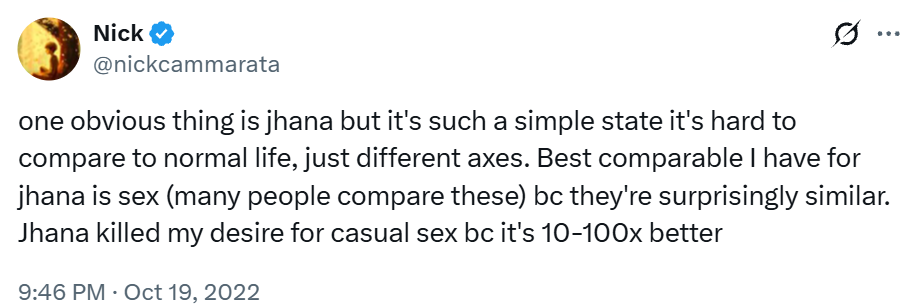
Claude, кстати, тоже такое любит.
Сергей Николенко
P.S. Как всегда, обсудить пост можно в моём телеграм-канале “Sineкура”.