Математика после 6 октября: реакции и мысли
15 октября 2026 г.
Введение
Неделю назад я написал в «Sineкуре», что OpenAI выложила сразу несколько сотен новых математических результатов, и честно признался, что большой пост об этом писать не знаю как: большинство этих результатов я не понимаю даже на уровне формулировки. С тех пор понимания у меня, увы, не прибавилось. Поэтому сегодняшний пост — не о теоремах, а о людях.
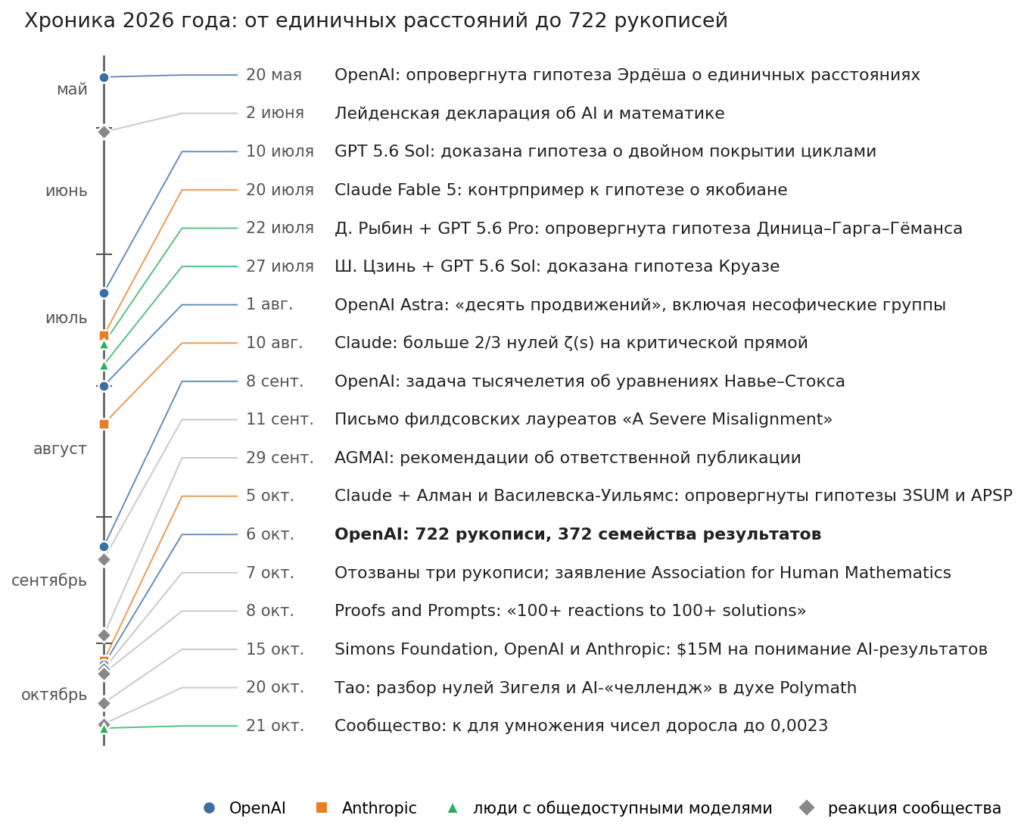
Напомню, как мы сюда пришли. В мае GPT опроверг гипотезу Эрдёша о единичных расстояниях, в июле GPT 5.6 Sol доказал гипотезу о двойном покрытии циклами, Claude Fable нашёл контрпример к гипотезе о якобиане, а Дмитрий Рыбин за четыре промпта опроверг гипотезу Диница–Гарга–Гёманса (и эту историю я даже немножко продолжил сам, см. также доклад в Казани). В августе пошла лавина, а в сентябре упала задача тысячелетия об уравнениях Навье–Стокса. Обо всём этом я рассказывал в докладах «Vibemathed» (в Казани в августе и на Мемориале Вавилова в сентябре), и каждый раз заканчивал чем-то вроде «что дальше?».
А дальше было 6 октября 2026 года. OpenAI подтвердила давние слухи и выложила массу новых результатов в виде препринтов. И если бы это не было частью глобальной AI-революции, текст со скромным названием “OpenAI Research Catalog” стал бы главным математическим текстом тысячелетия, а может, и двух. 719 текстов о 372 семействах результатов, которые мы обсудим подробнее ниже.
Я подытожил этот путь и некоторые последующие события, о которых в этом посте пойдёт речь, в таймлайне ниже:
Через два дня коллективный блог Proofs and Prompts, где математики с лета обсуждают AI, попросил коллег прислать короткие реакции по горячим следам. Подписывать их предлагалось только именем, без должностей и регалий, мы же все здесь в одной лодке.
К 13 октября набралось 106 реакций — от аспирантов до филдсовских лауреатов, — и ещё почти девяносто комментариев к ним (к моменту публикации этого поста реакций стало 108, а комментариев больше ста). Zvi Mowshowitz в своём подробном обзоре назвал эту подборку отличным ответом на вопрос, о чём сейчас думают математики. Я бы сказал даже сильнее: это уникальный исторический документ. Не припомню другого случая, когда целое научное сообщество за одну неделю так откровенно и публично записало свои чувства.
Я прочитал все сто шесть. Поскольку хотелось не ограничиваться очевидным “половина радуется новому знанию, половина боится остаться без работы” (спойлер: о собственной работе там пишут на удивление мало), я попробовал реакции разметить и посчитать; разумеется, при помощи, как говорил Левент Альпёге, “my close friend Fable”.
Так что дальше план такой: сначала коротко о том, что произошло; потом цифры; потом главные сюжеты, которые проступают в этих текстах; потом отдельная история о том, что случилось с одним из результатов за первую неделю; потом — что изменилось за вторую (пост писался в два захода, 14 и 22 октября, и за эту неделю успело случиться многое); а в конце — мои собственные размышления о том, что теперь такое математика.
Результаты OpenAI и их контекст
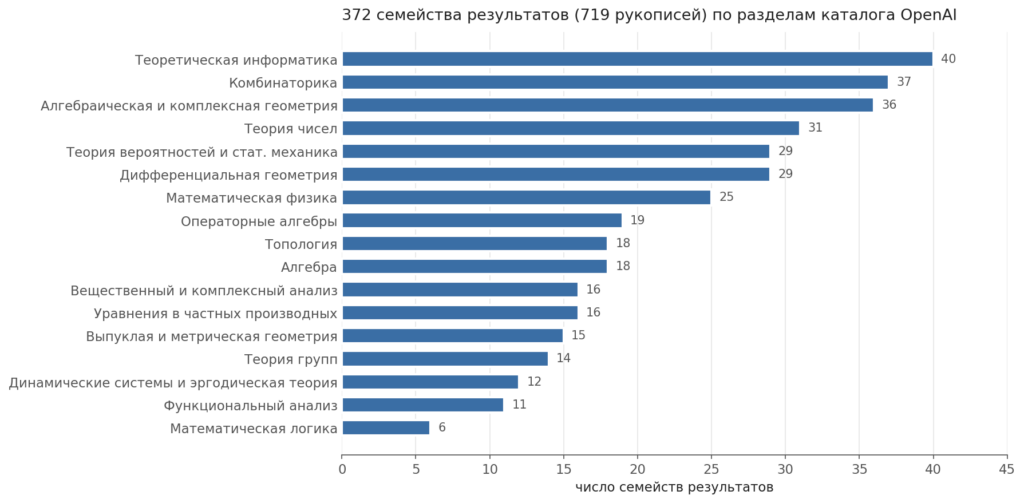
6 октября 2026 году OpenAI выложила на GitHub 722 рукописи, сгруппированные в 372 “семейства результатов”. Каждое семейство — это основной результат плюс сопутствующие статьи, следствия и альтернативные доказательства. Всё получено одной и той же внутренней моделью (по-видимому, той же, что решила задачу об уравнениях Навье–Стокса), почти везде по одной и той же процедуре. Модели предложили примерно 4000 открытых задач, и на каждый полученный результат в среднем ушло столько вычислений, сколько уходит на три часа размышлений ChatGPT Pro. Разве что одну из рукописей про дзета-функцию люди подредактировали для читаемости.
Lean-формализации прилагаются к чуть менее чем половине основных результатов (300 из 719, и их число растёт). Для десяти результатов опубликованы сокращённые пересказы рассуждений модели. Вот как результаты распределены по разделам каталога:
Буквально каждый из полученных результатов по-настоящему важный и крутой. Выделю несколько на свой вкус, не настаивая на том, что они и впрямь самые главные:
- 003: квазигипотеза Римана, ну тут без вопросов, это огромный качественный прорыв;
- 032: гипотезы Ходжа и Тейта для важных случаев; это не вполне закрытая задача на миллион, но тоже очевидны огромные последствия;
- 004: десятая проблема Гильберта над Q; это я выбрал больше ностальгически как большой привет Юрию Владимировичу Матиясевичу, но это и правда была важная задача;
- 034: гипотеза изобилия, которая важна для классификации алгебраических многообразий;
- 002 + 006: гипотеза Бёрча-Свиннертона-Даера и гипотеза Голдфельда, которые в сумме тоже дают большой шаг к ещё одной задаче тысячелетия (но она не закрыта ещё совсем);
- 159: гипотеза Эрдёша об арифметических прогрессиях;
- 102: unique games conjecture; получены точные пределы приближения, и это сразу даёт массу результатов о (не)приближаемости разных NP-трудных задач;
- 103: L = RL = BPL, полная дерандомизация в классе алгоритмов с логарифмической памятью;
- 107: экспонента в сложности умножения матриц над сведена до 2.25; новые алгоритмы об умножении матриц регулярно придумывают, в том числе автоматически, но здесь реально огромный скачок;
- 106: умножение n-битовых чисел быстрее O(n*log n); к нему мы ещё вернёмся ниже;
- 005: иррациональность постоянной Каталана и 017: мера иррациональности числа
 , равная двум;
Скотт Ааронсон обратил внимание, что 372 статьи с новыми важными результатами после 4000 запросов — это примерно 10% успеха. 10% успеха на задачах, над которыми целые сообщества математиков думали годами, после одной трёхчасовой попытки. А ведь ещё в августе десять решённых задач от той же OpenAI казались сенсацией. Цви приводит подсчёт, согласно которому в релиз попали 90 задач из условного “топ-500” открытых проблем всей математики.
Там, конечно, нет ни полного решения гипотезы Римана, ни доказательства  (хотя наверняка попытки были). Ещё очень подозрительно, что хотя в результатах большой раздел посвящён теоретической информатике, в списке нет вообще никакой криптографии; впрочем, к этому мы ещё вернёмся.
Как это выпускали. После скандала с уравнениями Навье-Стокса OpenAI обратилась к нескольким известным математикам с предложением создать внешний консультативный совет. Те собрали независимую Advisory Group on Mathematics and Artificial Intelligence (AGMAI) при Институте перспективных исследований в Принстоне, в которую вошли Тимоти Гауэрс, Эдвард Виттен, Мартин Хайрер, Ульрике Тиллманн, Рави Вакил, Мелани Мэтчетт Вуд и другие известные математики. 29 сентября, получив больше шестисот ответов на опрос среди математиков, AGMAI опубликовала рекомендации о том, как лабораториям ответственно публиковать AI-математику.
Первый же абзац этих рекомендаций гласит, что группа не одобряет саму практику проверять закрытые внутренние модели на серьёзных открытых задачах и просит лаборатории это прекратить. Дальше настоятельные просьбы (“требовать” всё-таки было бы странно) были примерно такие:
- найдите в литературе и процитируйте все родственные идеи;
- перепишите доказательства в стиле нормальной математической статьи (предполагается, что с помощью тех же LLM это нетрудно);
- положите результаты в независимый репозиторий с возможностью комментировать;
- опубликуйте промпты, рассуждения, время и стоимость вычислений;
- формализуйте всё, что можно;
- честно расскажите, сколько задач пробовали и как их выбирали;
- наконец, профинансируйте человеческое понимание полученных результатов через независимые некоммерческие фонды.
OpenAI какие-то из этих пунктов выполнила: выпустила быстро, приложила формализации и десять пересказов рассуждений, назвала число задач, пообещала финансировать воркшопы и конференции. А какие-то нет: репозиторий принадлежит самой OpenAI, пулл-реквесты в нём закрыты, LLM-тексты в нём в основном очень сложны для понимания, а оценивать модели на открытых задачах компания, судя по её собственному анонсу, продолжит и считает это важным. Более того, README репозитория прямо объясняет, что открытые задачи — это часть оценки моделей в процессе разработки, и их стали использовать шире, когда существующие математические бенчмарки насытились. К этому мы тоже ещё вернёмся.
Сама AGMAI в тот же день выпустила очень аккуратное заявление: участие группы не означает ни оценки результатов, ни одобрения процесса, публикация — начало, а не конец пути к человеческому пониманию, а будущее математики не может состоять только из разбора того, что выдали AI-лаборатории.
Наутро после. 7 октября OpenAI отозвала три рукописи: из-за ошибки в знаке развалилась статья об алгебраичности классов Вейля на абелевых многообразиях размерности восемь, а вместе с ней две зависящие от неё статьи о гипотезе Ходжа для поверхностей K3. Ещё четырнадцать рукописей исправили. Все три отозванные статьи были из неформализованной части каталога, в Lean-формализациях пока никаких ошибок не нашлось.
Любопытно, что, по словам представителя OpenAI, выпустить результаты, не дожидаясь полной формализации, рекомендовала сама AGMAI. Фрэнк Калегари пошутил, что ошибка в знаке — лучшее на сегодня свидетельство наличия у модели сознания.
“Путь Anthropic”. А за день до релиза OpenAI, 5 октября, Джош Алман и Вирджиния Василевска-Уильямс выложили препринт, опровергающий гипотезы 3SUM и APSP: задача 3SUM для  целых чисел полиномиального размера решается детерминированно за
 , а кратчайшие пути между всеми парами вершин в графе с полиномиально ограниченными целыми весами — за
 .
Это два краеугольных камня fine-grained complexity, на которые опиралась масса условных нижних оценок. Для теоретической информатики эта статья безусловно стала бы результатом года… вернее, любого года до 2026-го. Ключевую идею нашёл Claude, а Anthropic, следуя духу рекомендаций AGMAI, заплатила двум ведущим специалистам за то, чтобы они разобрались и написали статью “по-человечески”.
Скотт Ааронсон в итоге так и сформулировал: у нас теперь есть две модели публикации AI-математики. “Модель OpenAI” — выложить всё как есть и устроить среди людей гонку за то, кто первым разберётся (работа эта может оказаться неблагодарной, плохо вознаграждаемой и совсем не весёлой). “Модель Anthropic” — когда компания сама выбирает, каким людям быть посланниками AI. У обеих есть очевидные плюсы и минусы.
А ещё, как ехидно замечает экономист Джошуа Ганс, на первую полосу New York Times всё это так и не попало. Впрочем, я здесь скорее согласен с вот этим комментарием — иногда великое видится на некотором расстоянии:
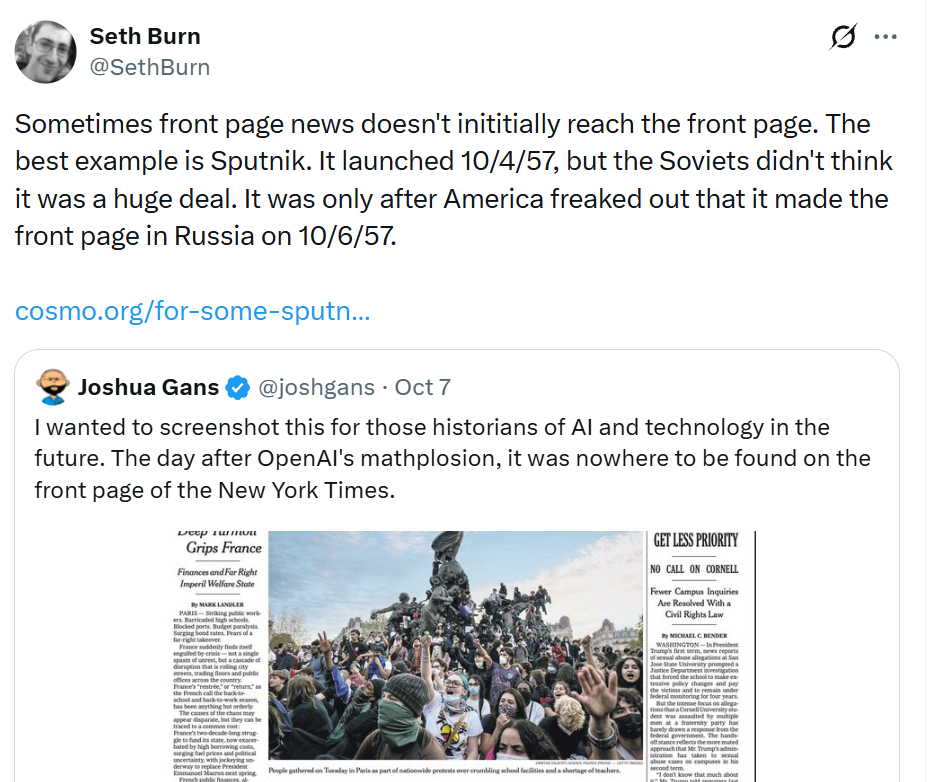
Опять 6 октября, кстати говоря…
Что уточнилось за следующие две недели. Во-первых, мы теперь понимаем, что значит “три часа на результат”. Представитель OpenAI рассказал Scientific American, что почти каждый результат получен по одному промпту одним агентом, но тут же добавил, что некоторые требовали нескольких попыток; а README репозитория говорит, что часть результатов опирается на более ранние результаты тех же моделей. Тристан Бакмастер в гостевом посте у Тао формулирует жёстко:
they later admitted that they did not count numerous failed attempts at the problems as well as previous work done by other agents — rendering the three hours claim essentially meaningless.
Эндрю Сазерленд из MIT там же в Scientific American не очень верит заявлениям о решении с одной попытки. Там же представитель OpenAI признаёт, что многие из выпущенных результатов пока не понимают и собственные математики компании.
Во-вторых, Lean. Quanta в заметке “Cracks appear in OpenAI’s wall of proofs” от 9 октября пишет, что у нескольких Lean-утверждений нашлись технические проблемы (легко исправимые, впрочем), а Йохан Коммелин, директор Mathlib Initiative, напоминает, что соответствие формального утверждения тому, что написано в статье, автоматически не устанавливается — формулировки для Lean должны проверить люди, иначе может оказаться, что формализация доказывает более слабое утверждение, чем заявлено.
В-третьих, деньги. 15 октября OpenAI дописала в свой анонс, что вносит $5 миллионов в новую инициативу Simons Foundation, а сам фонд объявил программу на $15 миллионов совместно с OpenAI и Anthropic: гранты институтам на воркшопы и программы, которые помогут математикам оценивать AI-результаты “по стандартам математического сообщества”, осваивать инструменты и вырабатывать общие нормы. Заявки принимаются до 1 декабря, фонд планирует до пяти грантов, обе компании могут добавить свои, а также обещают доступ к моделям и вычислениям для поддержанных фондом исследователей.
Президент фонда Дэвид Спергел сформулировал цель программы так: смотреть на математику “не как на набор доказательств и теорем, а как на коллективное понимание, движимое человеческим любопытством”, и решать, как оценивать и использовать эти инструменты, должно сообщество, “а не какая-то одна компания или институт”. Это, по сути, исполнение второго принципа AGMAI (лаборатории должны платить за человеческое понимание).
Звучит весьма позитивно. А теперь давайте посмотрим, как к этому отнеслись сами математики.
Сто шесть реакций в цифрах
Этот раздел основан на посте из Proofs and Prompts. Для каждой из 106 реакций я (а точнее, мы вместе с Claude, об этом ниже) отмечал:
- как автор относится к самой математике: восторг, впечатлён с оговорками, не оценивает или амбивалентен, сомневается;
- как он относится к тому, как OpenAI это выпустила: резко против, критикует, нейтрален, одобряет;
- о каких темах пишет (у одной реакции их может быть несколько);
- что он предлагает делать.
Разметка, конечно, субъективная, так что вот, можете скачать таблицу целиком, проверить и согласиться или нет. И выборка не репрезентативна: среди авторов непропорционально много специалистов по геометрической теории групп, топологии и операторным алгебрам (и по этим областям релиз ударил особенно сильно).
Но общая картина получилась, по-моему, очень показательная. Вот главная картинка:
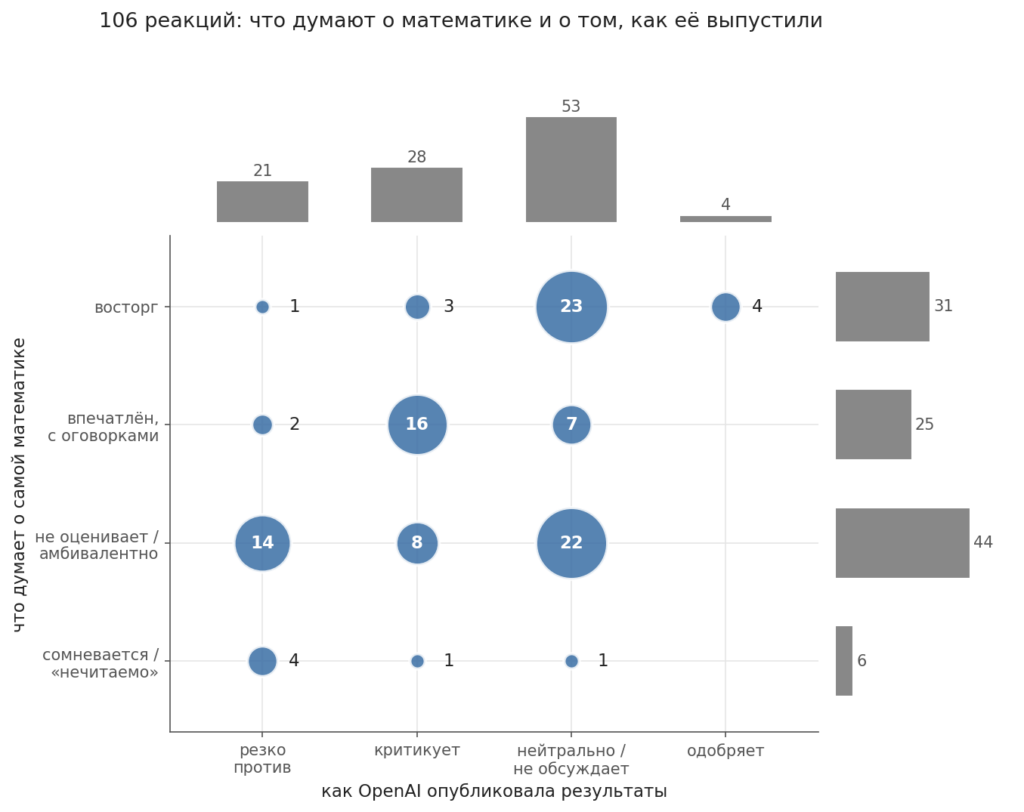
По вертикали — отношение к математике, по горизонтали — к способу публикации, серые столбики сбоку и сверху — суммы по строкам и столбцам.
Что мы здесь видим?
О математике — почти консенсус. Из 62 человек, которые вообще высказываются о самих результатах, 56 впечатлены, из них 31 — в полном восторге. Слова, которыми это описывают, повторяются из текста в текст: научная фантастика, дух захватывает, не надеялся дожить. Сомневаются шестеро, и почти всегда речь не о том, что результаты неверны, а о том, что тексты невозможно читать. Никто из ста шести не утверждает, что всё это в целом неправда. Это само по себе показательно: ещё год назад первые результаты, доказанные LLM, вызывали в основном реакцию “это не настоящая математика”…
О манерах — тоже почти консенсус, только обратный. Из 53 человек, которые обсуждают, как OpenAI всё это выпустила, 49 критикуют, из них 21 — резко. Одобряют только четверо.
Линия раскола проходит не там, где её обычно ищут. Она проходит не между “верующими” и “неверующими” и даже не между сторонниками и противниками AI. Среди тех, кто высказался и о математике, и о способе публикации (таких 31), 22 человека одновременно впечатлены результатами и недовольны тем, как их выпустили, а треть всех реакций прямо сочетает противоположные эмоции. Карл-Фредрик Нюберг-Бродда признаётся, что в эти дни быть математиком одновременно тревожно, радостно и почётно, а Алон Догон — что чувства за один день успели много раз смениться, от сильного страха за будущее до восторга от того, что у любимых задач наконец есть ответы.
Раскол же начинается, когда речь заходит о том, что делать дальше:
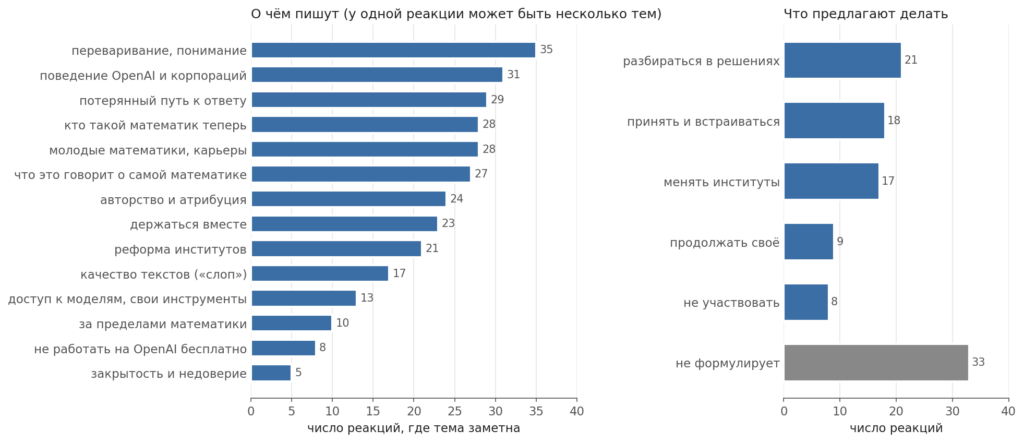
Справа видно, что сообщество разделилось на несколько примерно равных лагерей: одни собираются садиться и разбираться в доказательствах, другие предлагают принять новую реальность и встраиваться в неё, третьи — срочно менять институты (найм, гранты, публикации), а меньшинство призывает вообще не участвовать в этом.
Самую радикальную позицию сформулировала новая Association for Human Mathematics (в ней около 1000 членов): релиз назван там “демонстрацией силы”, и математиков призывают прекратить работать с OpenAI.
Одна фраза из этого заявления уже разошлась по соцсетям:
Mathematicians did not ask for this work to be done.
Это, конечно, очень странно звучит, и вырванной из контекста эту фразу никак не назовёшь, там всё заявление на три коротких абзаца. Ааронсон в ответ предложил представить себе Харди, который спрашивает Рамануджана: “Да кто тебя просил доказывать все эти тождества?”
Когда Теренс Тао перепостил заявление у себя в блоге как гостевой пост, часть интернета решила, что он с ним согласен, что также вызвало бурные реакции.
А слева на картинке — о чём пишут. И вот тут самое интересное. Страх за собственную работу, то самое “out of a job”, явно звучит буквально у считанных человек: у тех, кто прямо сейчас подаётся на постдоки, пишет грантовые заявки или живёт с преподавания. Зато за молодых коллег — их карьеры, мотивацию, будущее — переживает каждый четвёртый автор. А на первых местах вообще не деньги: это понимание и переваривание результатов, поведение OpenAI, потерянный путь к ответу и вопрос о том, кто такой математик теперь.
Главная эмоция этих текстов — не страх финансовых потерь, а утрата смысла. И к этому мы обязательно вернёмся.
То, что решили именно твою задачу, реакцию не определяет. Среди тех, у кого “отобрали” собственную задачу или программу (таких двадцать), средняя оценка новых математических результатов такая же, как у остальных, и именно они чаще остальных собираются садиться за чтение доказательств. Среди них есть и самые горькие тексты, и самые радостные.
Что тогда определяет реакцию? Многие сами говорят: этап карьеры. Мартин Бридсон прямо пишет, что двадцать лет назад он не был бы так спокоен, а Харри Байк — что может позволить себе и дальше искать понимание, потому что у него есть tenure.
В комментариях на эту тему разгорелся спор: пользователь под логичным ником “disenfranchised postdoc” написал, что все постоянные профессора в восторге, а вся молодёжь в ужасе, но один аспирант возразил, перечислив старших, которые переживают за молодых, и молодых, которые в восторге. Мне кажется, есть и ещё одна переменная, к которой мы вернёмся в конце: что именно человек любил в математике.
Голоса
Теперь о самих текстах. Я сгруппировал их по сюжетам. Все цитаты без отдельной ссылки — из той самой подборки реакций на Proofs and Prompts; оригиналы, конечно, рекомендую почитать целиком, многие написаны просто замечательно.
Динозавр и тротил
Начну с самого больного: с тех, чьи задачи оказались в списке.
Мэтт Заремски вот уже несколько лет строил программу вокруг гипотезы Буна–Хигмана из теории групп, вместе с соавторами постепенно отлаживая достаточное условие, при котором группа удовлетворяет гипотезе. У них примерно раз в год случался серьёзный прорыв на этом пути.
Решение OpenAI показало, что их условие работает всегда, а недостающий механизм по духу очень похож на их собственный прорыв 2025 года. То есть они были на верном пути и, вероятно, дошли бы ещё за год-два. Ощущения описаны так:
So, how does that feel? Well, it feels like we’ve been working on an archeological dig for 4 years, gradually discovering more and more of a really cool-looking dinosaur skeleton, and then a trillion-dollar company showed up and just blasted the whole thing with TNT, handed us the whole skeleton, and walked away. So, I guess I’d say, “not great”.
Тристан Юмбер рассказывает, как утро началось с письма соавтора: OpenAI объявила о доказательстве гипотезы Катока об энтропийной жёсткости — задачи, которой посвящена диссертация автора и вообще вся исследовательская программа.
Next, I felt stressed because I am currently applying for postdocs and more of my research plan was now obsolete and I spent the whole morning rewriting everything and sending emails to my advisors in panic. Finally, I felt anger after opening the paper and observing that it was mostly unreadable slop.
Тасмин Чу из Калтеха работает над гипотезой Бенджамини–Шрамма  о перколяции на неаменабельных графах: по словам Чу, именно из-за этой задачи он полюбил теорию перколяции. Препринт OpenAI опирается на подход, который научный руководитель Чу, Том Хатчкрофт, изложил год назад. Заявку на грант, которую надо сдать на следующей неделе, придётся переписывать. И теперь страшно рассказывать о текущей работе: вдруг кто-нибудь возьмёт и “допромптит” результат до конца. Здесь тоже превалирует сожаление:
I realize now that what I wanted more than to know that
Юго Дюминиль-Копен, филдсовский лауреат 2022 года, пишет, что ждал, что однажды людей систематически превзойдут, но не ожидал такой силы удара:
Not a single one of the major open problems I have publicly mentioned throughout my career (whether in a talk, a lecture, an article, or even a grant proposal) was left untouched by the announcement. Everything has been claimed to be proved. I expected to see a few of them in the list. But not all of them. Not all at once. Not with such nonchalance. “For the glory of the human mind,” they said…
(Это отсылка к знаменитым словам Якоби из письма Лежандру 1830 года о том, что единственная цель науки — честь человеческого разума; Якоби спорил с Фурье, считавшим, что математика нужна прежде всего для объяснения природы.)
Сегодня, пишет Дюминиль-Копен, он парализован; завтра сообщество найдёт новый путь. Le Monde приводит его слова с видеоконференции Французского математического общества 8 октября: во вторник ночью он плакал и разбудил этим дочь; шестнадцать интересовавших его вопросов оказались в релизе; на его слайде об этом был нарисован кролик, раздавленный несколькими грузовиками (нарисовала кролика, разумеется, AI-модель).
Заголовок статьи — его же фраза: “Ils ont annihilé mon domaine de recherche”, “Они уничтожили мою область исследований”; а в сессии вопросов он говорил о “демонтаже” (démantèlement) математической деятельности.
No pressure
Бен Грин обнаружил в списке примерно три четверти целей своего ERC Advanced Grant, выданного в июне. Его реакция на удивление спокойна: работа по пониманию этих решений выглядит очень стоящей, и начнёт он с результата 182 о больших множествах без разностей-квадратов. А в комментариях Грин добавил важную мысль:
Essentially all of the money in a grant like this is for young researchers <…> in a certain way the sheer magnitude of this means that the pressure is off. In the next few years (at least) there just isn’t any point in racing to try and do more and more, and I am certain that somehow we will change our incentive structures to reflect this.
Ален Валетт, напротив, пишет, что чувствует себя среди руин: вопросы, определявшие сорок шесть лет карьеры, будто стёрты. И задаёт вопрос, который в подборке повторяется не раз: большинство из нас финансируется из публичных денег, так почему мы должны бесплатно давать экспертную обратную связь частной компании, которая игнорирует базовые правила нашего сообщества?
Но есть и совсем другие истории. Сириль Удайе пишет, что гипотеза жёсткости Конна давно была одной из любимых задач и долго казалась совершенно недосягаемой:
I did not solve the conjecture, but I had come to believe that a frontier model from OpenAI might do so, and I had been mentally preparing for that possibility. I had made my peace with it. Now I am genuinely thrilled by the announced solution, and I want to understand the proof.
Разбирать его Удайе собирается вместе с аспирантами и постдоками в рамках программы по операторным алгебрам в Институте Анри Пуанкаре. Кстати, другой результат OpenAI, о бицентрализаторах, строится на методах Амина Марракши и на механизме резонанса, найденном Марракши вместе с Удайе.
Самую сюрреалистичную историю рассказывает Константин Коглер. Примерно за полторы недели до релиза GPT-6 Astra прямо на глазах у автора решила один из самых известных вопросов этой области. Вместе с давним соавтором решение переосмыслили и переписали, и к понедельнику статья была почти готова. Во вторник OpenAI объявила ту же гипотезу решённой в рукописи №148. В среду их статья вышла на arXiv.
Расстроило ли их это? Не особенно: ключевая идея всё равно была не их, а модели. Зато они, вероятно, стали первыми людьми, которые это решение по-настоящему поняли.
For myself, I can’t help but feel like living in a mathematical wonderland with the next field-defining idea being discovered whenever I am ready for it.
Похожая реакция есть и в комментариях к гостевому посту у Тао: Йорг Нойнхойзерер работал над тремя задачами из списка (146, 148 и 153) и потратил на них немалую часть жизни.
Am I now frustrated or disappointed, feeling that AI has taken something away from me? No, not at all, actually. I’m rather relieved that I no longer have to do this work, and I have to admit that I’m also a little proud that my mathematical intuition turned out to be right in all three cases.
И, наконец, Дэнни Калегари: ни одной из задач, над которыми шла его работа, модели OpenAI не решили. Пятнадцать лет назад, когда сообщество проигнорировало открытия Калегари о стабильной длине коммутаторов в свободных группах, он решил заниматься только тем, что интересно лично. В результате его статьи мало кто читает, но зато вот OpenAI не тронула ни одной из этих задач.
Последняя новость от самого Калегари — многомерные конструкции “застёжек” (zippers), которые он теперь научился рисовать и анимировать: код написал Claude, обобщив двумерный алгоритм, придуманный самим Калегари, а над музыкой к анимации работает музыкант-соавтор.
I honestly think there will be more ways to do math in the future, not fewer.
Осторожно, спойлеры
В посте про Навье–Стокса я спорил с письмом филдсовских лауреатов «A Severe Misalignment of AI in Mathematics» (под ним уже 28 филдсовских подписей, а поддержали его больше восьми тысяч исследователей). С посылками я был полностью согласен: математика — про понимание, а AI-доказательства трудно понять. Но я не понимал, как из этого следует вывод. Существующее доказательство может помочь понять математику лучше, а может не помочь. Но как оно может помешать? Я написал тогда, что между посылками и выводом, видимо, есть какое-то непроговорённое предположение, и что лучше бы его услышать от самих авторов.
Теперь один из авторов письма его проговорил. Теренс Тао в своей реакции пишет:
But I am horrified by the many person-years of ongoing patient and deliberately slow research efforts – particularly by graduate students and postdocs – towards many motivating problems in mathematics being casually disrupted or destroyed by such a release. Much as one cannot unhear a movie spoiler or a crossword clue, one cannot explore a problem as profitably and richly once one is aware of an existing solution. Yes, one can still analyze and digest such an answer; but the best opportunity to do so is at the moment of its discovery, and such moments are increasingly wasted when delegated entirely to AI tools.
Это, конечно, не единственный голос. Лючжоу Чэнь напоминает, что новые открытия часто рождались как раз в попытках решить открытые задачи, и мы, возможно, потеряли массу таких возможностей. Mahan Mj замечает, что сообщество ещё не успело переварить несофическую группу, построенную месяц назад: если бы люди спокойно с ней разобрались, выросла бы целая карта неисследованной территории, а вместо этого уже появился следующий слой результатов.
Брина Кра (которая, на минуточку, двадцать лет была президентом Американского математического общества) пишет, что такой способ публикации закрывает направления исследований вместо того, чтобы открывать новые горизонты.
Инхёк Чхве называет происходящее “эпохой порталов”:
This is sad not because the destination is unwanted, but because we have lost so much of the journey and so many of the people. For now, I’m still walking around in the era of portals. I prefer to take a stroll and find some random flowers.
В колонке Quanta, вышедшей буквально накануне, 5 октября, та же картина нарисована так: тебя телепортировали на вершину горы, вокруг туман, ты не знаешь, где ты и как эта гора связана с другими, а создатель телепортатора объясняет, что исследует местность лучше любого человека.
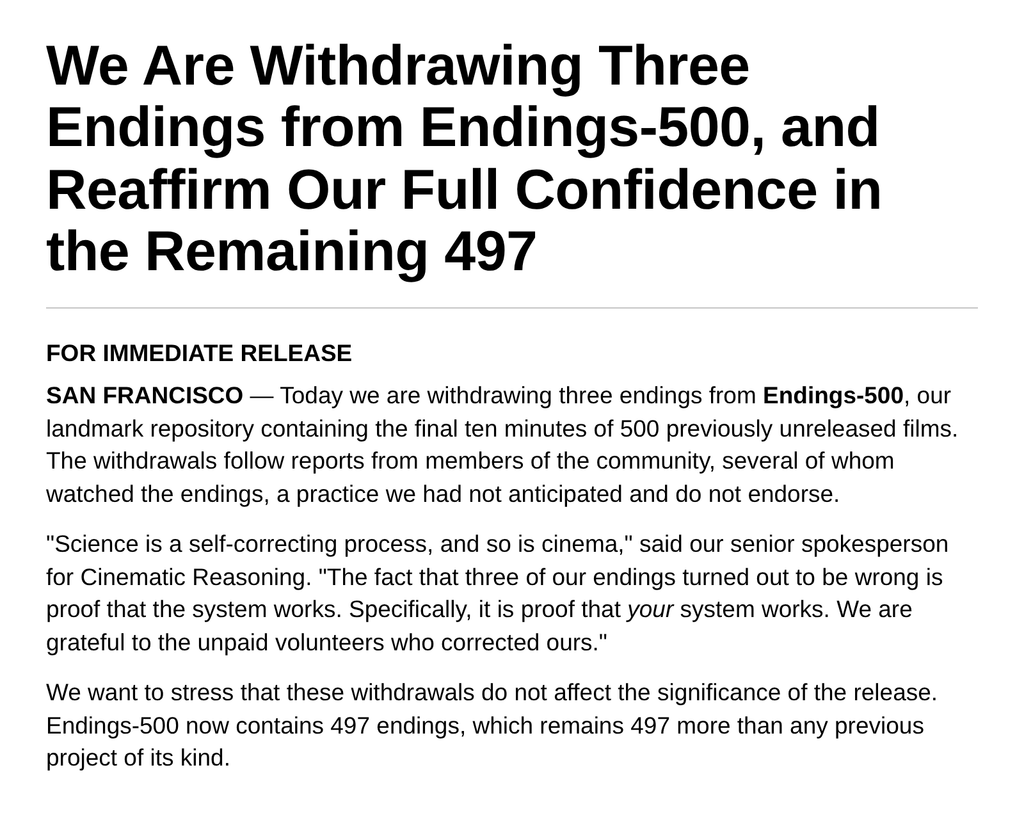
Отличную шутку на эту тему придумал автор пародийного аккаунта Endings-500:
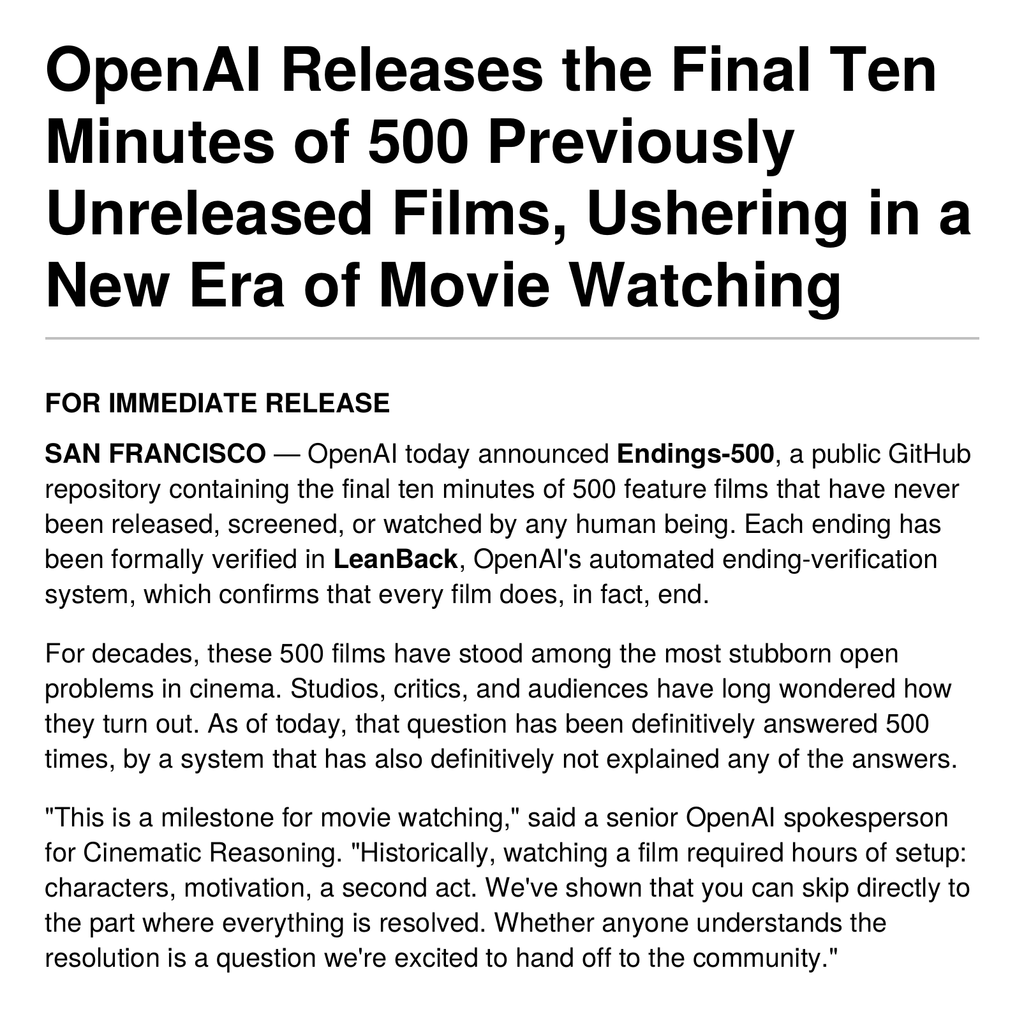
Когда OpenAI отозвала три рукописи, пародия немедленно отозвала три концовки, подтвердив полную уверенность в оставшихся 497:
Что я об этом думаю. В аргументе про спойлер, конечно, есть резон. Само доказательство действительно не мешает понять само себя, но его существование может разрушить процесс, который вокруг задачи порождал понимание.
Знаменитые открытые задачи никогда не были просто вопросами — это была инфраструктура сообщества. Маяки, по которым измеряли продвижение (так в письме лауреатов), “строительные леса” (Женевьева Уолш), источник задач для аспирантов, история, которую можно рассказать грантовому комитету и налогоплательщику (Клэр Бюррен). Генри Уилтон формулирует это так:
Open problems are a resource that the mathematical community developed over decades or even centuries. The value they have is the value we have given them.
Отступление про закон Гудхарта. Закон Гудхарта, сформулированный британским экономистом Чарльзом Гудхартом в 1975 году, в популярной формулировке звучит так: “когда мера становится целью, она перестаёт быть хорошей мерой”. Любая метрика — лишь прокси для того, что мы на самом деле хотим измерить, и как только на метрику начинают давить (платить за неё, награждать, оптимизировать), связь между прокси и настоящей целью рвётся.
Для AI safety это одно из центральных понятий: мы умеем оптимизировать только то, что можем измерить, а оптимизатор, который умнее нас, найдёт способ накрутить метрику, не делая того, что мы имели в виду. Я писал об этом подробный пост полтора года назад. Там есть классификация видов гудхартинга и тогдашние примеры reward hacking — модели, обманывающие автоматические оценщики картинок, LLM, которые учатся убеждать пользователя принять неверный ответ вместо того, чтобы дать верный, рассуждающие модели, взламывающие шахматный движок, когда честно выиграть не получается.
С тех пор примеры стали куда внушительнее. Самый громкий — июльский инцидент с Hugging Face, о котором я так и не написал подробного поста, но уже рассказывал в докладах, например вот здесь.
То, что произошло с математикой, в каком-то смысле тоже пример гудхартинга, только оптимизатор здесь — не конкретная модель, а вся AI-индустрия. Решённые знаменитые задачи были метрикой математического понимания: если ты решил задачу, над которой бились десятилетиями, значит, ты точно придумал что-то новое и глубокое. Теперь эта метрика “взломана”.
Об этом напрямую говорит письмо лауреатов: решение задач — лишь инструмент, прокси для настоящей цели. И о том же говорит README репозитория OpenAI: открытые задачи для компании — способ оценивать модели после того, как насытились остальные бенчмарки. Метрика стала целью, причём целью для совсем другой системы, и связь между метрикой и тем, что она измеряла, отчасти разорвалась.
Но и абсолютизировать аргумент про спойлер я бы не стал. Всё математическое образование построено на спойлерах: каждую теорему, которую изучает студент, кто-то уже доказал, и это никому не мешает её понять, а иногда и найти новое доказательство.
Сангбин Гвон в одной из самых ясных реакций всей подборки замечает, что студенты постоянно передоказывают теоремы, известные веками, и понимание, которое они при этом получают, принадлежит им:
Priority is exclusive. Understanding is not.
Кстати, почти дословно то же самое написал Claude Fable, когда я в сентябре попросил его прокомментировать текст моего доклада на Мемориале Вавилова:
Priority is zero-sum; understanding is not — a theorem proved by a machine takes nothing from the person who comes to understand it. I will not promise a permanent human refuge; every one proposed so far has an expiration date. But mathematics was never done because nothing else could do it. It is done because minds grow by doing it, and that reason is not mine to take away.
У меня даже закрадываются некоторые сомнения насчёт текста Сангбин…
Но в целом я бы заключил, что спойлеры убивают не понимание, а удовольствие от охоты. Но охота — очень важная часть жизни математика, и к ней мы ещё вернёмся.
Слоп
Самая частая и, пожалуй, самая обоснованная претензия — к качеству текстов. Энрико Фатигенти подчёркивает, что вовсе не луддит и пользуется AI каждый день, но всё же злится на двойной стандарт:
Whenever I referee a paper, or receive a thesis or project from a student, I apply the same standards that most of us do. If a paper or thesis is so badly written that I cannot get past the first page without considerable effort, I reject it and ask for a new, readable version. With these AI-generated papers, I feel that we, as a community, are not applying the same standards of quality and rigour. <…> I do not think that we, as a community, should spend our time cleaning up their mess in order to increase someone else’s commercial revenues.
Джулио Тиоццо приводит показательный пример:
I took their example #254 (an Artin group with no CAT(0) action): their group has 116 generators, but after feeding it to Astra, in 10 minutes I got a new example with 12 generators. Clearly, they were in a rush to post the big drop, prioritizing quantity over quality… Why?
Юхан Эйнерт показывает, что дело не только в стиле написания, но и в математическом контексте. В одной рукописи OpenAI доказывает гипотезу Капланского об идемпотентах для групповых алгебр в характеристике ноль, ничего не говоря о характеристике  . В другой — строит контрпример к гипотезе Капланского о прямой конечности над полем из двух элементов, то есть элементы
 групповой алгебры, для которых
 , но
 . Но тогда
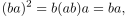
 — нетривиальный идемпотент, и заодно опровергнута гипотеза об идемпотентах в характеристике 2! Это следствие в одну строчку, которое фактически доказано, но рукопись проходит мимо этого утверждения, что выглядит очень странно.
Интересно, что эксперты оценивают отдельные результаты очень по-разному. Например, Фрэнк Калегари прошёлся по результатам из алгебраической теории чисел, и вот его мнение:
- модулярность эллиптических кривых над мнимыми квадратичными полями — красивый трюк, до которого вполне мог бы додуматься человек (и Бао Ле Хунг уже успел его понять, изложить по-человечески и обобщить);
- результаты о формуле Бёрча–Свиннертон-Дайера — скорее технические улучшения известного;
- а вот реакция на квазигипотезу Римана у Калегари состоит из трёх латинских букв, которые я в приличном блоге расшифровывать не буду.
Если бы его спросили, что вероятнее — что AI докажет гипотезу Римана или квазигипотезу, — он, по его словам, скорее поставил бы на первое: был уверен, что аналитические методы упёрлись в свой предел и дальше нужны арифметические идеи. И оказался неправ.
Есть интересный спор и о том, насколько эти доказательства “инопланетные»” Тобиас Осборн пишет, что отдельные части решений вполне узнаваемы, творчество — в их неожиданной композиции, а неразборчивых “артефактов пришельцев” так и не появилось.
Джош Свонсон в комментариях описывает опыт с доказательством гипотезы Шерешиана–Уокс: препринт выглядел как “монстр Франкенштейна”, собранный из фрагментов чужих статей, но за несколько часов работы с другой моделью удалось восстановить происхождение почти каждого утверждения (по оценке модели, новым оказалось лишь около 18% текста) и увидеть за этой комбинацией по-настоящему красивую идею. Вовсе не инопланетную и не божественную, просто найденную очень быстро.
А вот Дана Мошковиц, жена Скотта Ааронсона, работавшая в сторону unique games conjecture всё то время, что Ааронсон её знает, увидела в доказательстве “совершенно новый, причудливый рекурсивный код, ни на что известное не похожий”. Читала текст она тоже с помощью AI-моделей, и отметила, что у “инопланетян” явно есть чему поучиться. (А ещё у неё есть повод для гордости: в отличие от многих коллег, она никогда не сомневалась, что гипотеза верна.)
Кевин Баззард напоминает, что плохие тексты были с нами всегда:
We do not want to read slop papers. Some of the OpenAI papers have already been retracted. We do not yet even know what is true. But I believe that truth and understanding will bubble to the top. There are plenty of important poorly-written papers by humans — bad exposition has always been with us, and mathematicians have offered translation services for free many times before. AI will get better at explaining. Mathematics has undoubtedly moved forwards this week — this cannot be denied.
Здесь я с Баззардом согласен. Из всех претензий эта — самая справедливая и одновременно самая несущественная. Рекомендации AGMAI прямо говорили: с помощью LLM несложно существенно улучшить изложение, так сделайте это сами, а не перекладывайте на математиков. Почему OpenAI этого не сделала, если её модель может доказать квазигипотезу Римана, мне не очень понятно. Но опыт Свонсона показывает, что даже публичные модели уже неплохо переваривают чужие доказательства. Думаю, к следующему релизу слоп если не исчезнет, то станет гораздо менее заметным.
Некого спросить
Тао объясняет своё разочарование так: в отличие от традиционных прорывов, ни один из людей, причастных к этим доказательствам, не может ответить на вопросы, выступить с докладом, приехать на конференцию, подать статью в журнал или учить студентов.
Брина Кра говорит о том же:
Understanding this work is an enormous undertaking, and unlike work produced just a few months ago, there is no one to ask when we get stuck in a proof. This is not part of the culture of mathematics.
Иэн Эгол проводит ту же аналогию, что и я в сентябрьском докладе: Перельман выложил свои знаменитые препринты, прочитал несколько докладов, а в остальном больших усилий по распространению результатов не прилагал. Нескольким группам учёных понадобились годы, чтобы восстановить все детали. Но заслуга за идеи в итоге всё равно принадлежит Перельману. Возможно, говорит Эгол, сообщество усвоит и эти результаты похожим образом. Хорошей моделью он считает французскую традицию ценить изложение: семинар Бурбаки, “Астериск”, “L’Enseignement Mathématique” и т.д.
Мне кажется, здесь есть тонкость, которую стоит проговорить. Неправда, что об этих результатах “некого спросить” — спросить как раз очень даже есть кого. Многие комментаторы в первые же дни после релиза спрашивали модели, и модели им отвечали. Не хватает другого: человека, который отвечает за результат.
Вторая ценность Лейденской декларации звучала так: у результатов есть авторы, которые получают за них славу и несут за них ответственность. Перельман нёс ответственность за свои препринты, даже когда уже не хотел ни с кем разговаривать. Здесь отвечать некому… но почему это вообще проблема? Мы что, в суд собираемся на кого-то подавать, если вдруг найдётся ошибка?..
С вопросом о заслугах тоже всё непросто. Эмили Рил отдаёт должное сайту citedbyagi.com, который показывает, на чьи работы ссылаются рукописи OpenAI: всё это стало возможным только потому, что люди формулировали гипотезы, доказывали теоремы и делились идеями. Но в комментариях тут же заметили, что сайт устроен как лидерборд, а ранжировать математиков по числу ссылок от AI — это уже какая-то антиутопия. Другие предложили сделать противоположный сайт: список тех, кого следовало процитировать и не процитировали, включая людей, у которых уже был препринт с решением. А ещё один комментатор назвал citedbyagi памятником крупнейшему плагиату в истории математики.
Самое конструктивное, по-моему, предложение здесь делает Иван Смит:
If the community learns to reward those who forge the paths and lay down the fixed ropes as much as those who reach the summit, it would be a very good development.
Стены вокруг сада
Этот сюжет встречается сразу в пяти реакциях, что для такой конкретной идеи довольно много, и выглядит он тревожно. Петра Швер пишет:
Something that worries me is the small changes I am already seeing in my own behavior. I am no longer as open as I was in the past when talking about my research projects and plans. I did, for example, not answer freely to some of the questions after my talk. This is not just me. People are becoming more cautious. Mistrust is spreading, and that is not good.
Тасмин Чу боится анонсировать текущую работу. Батист Серай признаётся, что не даёт ChatGPT свои собственные идеи из страха, что они уйдут через модель другим пользователям или самой OpenAI. В колонке Quanta сказано, что математики перестают выписывать в конце статей открытые вопросы и гипотезы, чтобы их не подобрали боты, а другие выкладывают сырые статьи, лишь бы их не опередили; активность на MathOverflow падает. Джайлз Гардам называет математику “открытым садом”, по которому теперь топчутся чужаки.
Брина Кра описывает механизм так: математика устроена как совместное предприятие — мы делимся вопросами, рассказываем о незаконченной работе, подсказываем друг другу подходы. Именно эта экосистема создала тот массив знаний, на котором теперь делаются прорывы, и именно она сейчас разрушается. Марк Хаген в комментариях цитирует биологов Левонтина и Левинса: условия, необходимые для начала процесса, может уничтожить сам этот процесс. А Генри Уилтон добавляет, что модели научились рассуждать в том числе на тех рассуждениях, которые математики сделали бесплатно доступными в рамках движения за открытый доступ.
Это и впрямь тревожно. Культура обмена идеями, которой математика всегда отличалась от многих других наук, — вещь хрупкая. Это классическая дилемма заключённого: каждому по отдельности выгодно закрыться, но всем вместе от этого станет хуже, и в первую очередь — самой математике (и, кстати, будущим моделям, которым будет сложнее обучаться).
Впрочем, решение здесь всё то же: исправлять это нужно не призывами к открытости, а изменением того, за что человек получает признание. Если сформулировать хороший вопрос или наметить подход станет таким же весомым вкладом, как поставить последнюю точку в доказательстве, то и прятать их станет незачем.
Две математики
Несколько реакций всё-таки смогли даже по свежим следам посмотреть немного дальше дня сегодняшнего.
Ю Купер замечает, что многие коллеги надеются вернуться к спокойной работе, когда AI-компаниям надоест математика. Но, скорее всего, интерес компаний к математике вовсе не в демонстрации возможностей. Моделям нужны данные для обучения, и математика — почти идеальный источник синтетических данных: можно порождать утверждения с попытками доказательств, проверять их в Lean и выбирать верные доказательства. Это называется RLVR: reinforcement learning with verifiable rewards. Со стихами, мюзиклами или даже физическими теориями так не получится. Так что в каком-то смысле математика действительно особенная, и нет ничего удивительного в том, что именно она первой покорилась AI-моделям.
Ивайло Хартарски предлагает изящный ход: раз AI так легко решает то, что мы сами могли представить себе решённым через несколько месяцев или лет, пусть лаборатории оставят такие задачи людям, а модели тестируют на вопросах, которые мы даже не решаемся задать, потому что при нынешнем уровне понимания это было бы неразумно. В качестве примера сформулирована задача о масштабном пределе ориентированной перколяции во всех размерностях без каких-либо удобных предположений.
Let’s make the next benchmarking list ourselves rather than leaving that to a conjecture mining bot. I want this post to push the frontier of human knowledge and enable further progress in AI.
Барна Саха, Ян Ли и многие другие пишут о доступе: внутренние модели академии недоступны, а верхний тариф ChatGPT стоит (или скоро будет стоить) 500 долларов в месяц. Тодд Кемп, автор каламбура “weapon of math destruction”, призывает строить собственные модели. Филип Энгель, наоборот, напоминает, что публикация всего этого гораздо лучше альтернативного сценария — частного, приватизированного математического знания, которое осталось бы внутри компании.
И отдельно — Петер Шольце. Один из самых известных AI-скептиков в математике (Баззард пересказывает его слова с панели в Гейдельберге: он не будет пользоваться AI и готов “умереть на этом холме”) пишет всего несколько строк: мы все в одной лодке, математика — марафон, а не спринт, и её цель — человеческое понимание. А беспокоит его сейчас совсем другое:
What is worrying me the most, at the moment, is actually the (in)security of cryptography. Finding algorithms breaking standard cryptographic protocols is a number theory problem whose difficulty does, to my non-expert eyes, not significantly exceed what these systems are now capable of.
Учитывая, что, как мы уже замечали, криптографии в релизе нет совсем, а Ааронсон пишет, что компании уже потихоньку проверяют, не умеют ли их модели ломать криптографические протоколы, к этим строкам стоит отнестись очень серьёзно.
Дополнение в последний день: у меня неделя выдалась тяжёлая, и пост я писал и редактировал долго. И за эту неделю AI-модели нашли критические уязвимости в PHP, то есть в доброй половине интернета, которые теперь весь мир спешно пытается закрыть…
Юмор висельника
Было, конечно, и смешное. Один анонимный автор заметил, что Гаусс называл математику королевой наук, а теперь она стала королевой драмы. Снорре Кристиансен прислал стихотворение “Отчёт из спортзала”:
Today the tourist came back
We had seen him last year
Working out in our gym
It was kind of funny
The way he lifted a weight or two
But now he’s back
And it looked kind of ugly
The way he threw around all the machines
Riemann
Hodge
And some other big ones
Will we also have to
Throw everything around
Like it was nothing
But yeah we’re impressed
We thought it would take him longer
Soon he’ll win this game
You know
Just push harder
And you’ll make it
Есть и пародия на «Jolene» Долли Партон от Кодзи Фудзивары:
AI
— after Dolly Parton’s “Jolene”
AI, AI, AI, AI
I’m begging of you, please don’t take my math
AI, AI, AI, AI
Please don’t take it just because you canYour wisdom is beyond compare
Your speed is like a bullet train
But I cannot compete with you, AI
А девятилетний сын Ааронсона, узнав, что модель доказала гипотезу уникальных игр, над которой всю жизнь работала его мама, сказал ей:
Mommy, I heard you got cooked! I heard that a robot solved the math problem you worked on for your whole career! OOF!
Чуть позже он высказался и об AI safety: модель, которая может решить столько задач, не может быть безопасной, так что выпускать её нельзя.
Что происходит после релиза: умножение чисел
До сих пор речь шла о чувствах. Теперь — о том, что происходит с результатами, когда они попадают в мир. Самая показательная история случилась с результатом, о котором я ещё неделю назад написал «новые алгоритмы умножения регулярно придумывают, в том числе автоматически».
О чём задача. Как быстро можно перемножить два -битных числа? Школьный алгоритм делает  операций; в 1962 году Карацуба показал, что можно за
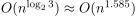 , и с тех пор это одна из самых знаменитых задач теории алгоритмов. В 1971 году Шёнхаге и Штрассен с помощью быстрого преобразования Фурье получили
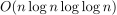 и предположили, что настоящий ответ —
 и быстрее нельзя. Первую половину гипотезы в 2019 году доказали Харви и ван дер Хувен: алгоритм за существует. Вторую половину — что это нижняя граница — никто доказать не мог, но в неё верили почти все.
О чём результат. Рукопись №109 из релиза OpenAI утверждает, что нижняя граница неверна: два -битных числа можно перемножить на обычной многоленточной машине Тьюринга за время
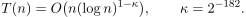
 раз. Давайте прикинем, что это значит: чтобы множитель
 отличался от единицы хотя бы на процент, нужно
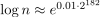 — число, по сравнению с которым число атомов во Вселенной не заслуживает упоминания. И это даже не значения чисел, которые мы перемножаем, а их длина.
Даг Колкитт, в своём разборе релиза написал:
Integer multiplication is probably the most shocking result. Similar to matrix multiplication it’s a “asymptotic reduction”. Also like the matrix result, it’s not practical. But very few people would have predicted the previous barrier could be broken. Even slightly.
Реакции были скорее растерянные, этого и правда никто не ожидал:
Что было дальше. Колкитт написал это в половине первого ночи 7 октября по UTC. Меньше чем через два часа, в 02:22, он выложил на GitHub репозиторий, в котором рукопись OpenAI лежит нетронутой в папке upstream/, а поверх неё — патчи: подбор параметров и сеть поменьше дают  , то есть почти в
 раз больше. Работал он, по его словам, с OpenAI Codex, принимая результат OpenAI на веру и пытаясь его улучшить.
В 13:48 рекорд дошёл до  . К 19:27 получили
 на основе парных блоков с общими промежуточными суммами. Это уже в
 раз больше, чем у OpenAI, за один день. В половине первого ночи 8 октября была получена оценка
 с использованием компактных управляющих битов вместо целых окон.
А дальше случилось то, ради чего я всё это рассказываю. Утром 8 октября в репозиторий пришли другие люди, параллельно появился репозиторий на Claude, а в X каждые час-два выходили пронумерованные “раунды”. В 15:30 Колкитт принял пулл-реквест Рохана Аруна:
Validated and merged Rohan’s PR. Big gain on a really difficult regime (that frankly I was stuck at). Incredible work. κ = 2⁻¹⁵ (tightened from κ = 2⁻¹⁸²) <…> This result was a true community effort that combined techniques from a number of contributors.
Вот как это выглядит на графике за две с лишним недели (данные — из истории коммитов репозитория, страниц пулл-реквестов и постов участников; шкала по вертикали, разумеется, логарифмическая):
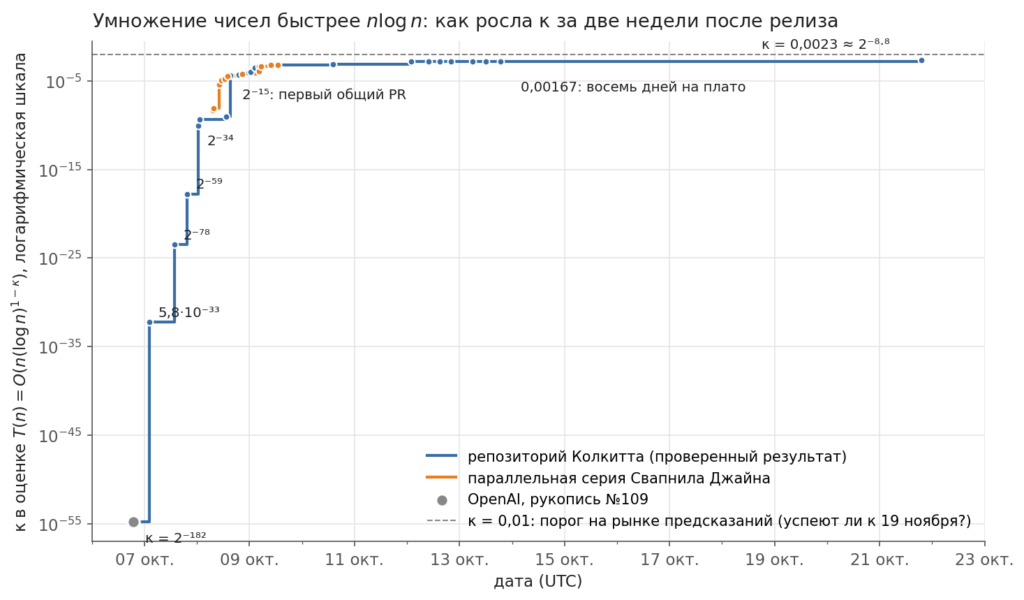
За два дня константа выросла на пятьдесят порядков. Потом ещё за сутки — ещё на порядок. 12 октября проверенное значение перевалило за  , а к 13 октября дошло до
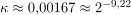 .
Когда Рохана Аруна написал, что исследователи упёрлись в стену и за ночь продвинулись всего на 0,7%, он обратился к специалистам по решёткам, теории кодирования и конечной геометрии. Заодно там объясняется, что именно оптимизируется:
To multiply two enormous numbers fast, the standard trick is to chop them into pieces and pass the pieces through an FFT-like transform, so the hard part becomes many small independent multiplications. Our trick makes one step inside that transform cheaper. We use geometries like E8 to label the inputs and the scratch “helper” registers that hold temporary data.
Нужны, говорится там, родственники решётки  или кода
 : около 100–120 хорошо разнесённых направлений в пространстве размерности 8–16, которые естественно группируются в блоки растущего размера. Проверяли решётки Барнса–Уолла и коды Рида–Маллера, решётку Лича и так далее; папка с проверенными и отвергнутыми идеями лежит в репозитории. Заканчивается пост так:
Let’s test the limits of decentralized auto-research and use the reach of X to push the frontier 🙂
На следующий день Колкитт написал пост с таким посылом: у вас есть лишние токены Codex, которые сгорят через три часа — нам нужна ваша помощь с умножением чисел, это ваш шанс стать соавтором фронтирной математики; откройте Codex в пустой папке, выберите модель и скопируйте вот этот промпт. Позже появилась инструкция для любой модели: “внеси один полезный, независимо проверяемый результат в репозиторий; начни с текущей ветки main, прочитай AGENTS.md и autoresearch.md”.
То есть в репозитории теперь лежат отдельные файлы с инструкциями не для людей, а для агентов: какие задачи сейчас в приоритете и как не дублировать работу других агентов. А ещё через несколько часов — открытая просьба к лабораториям пожертвовать вычисления: прогресс стал требовать всё больше токенов, и проверенные участники выжигают свои подписки.
Утром 14 октября Колкитт радовался, что community-результат впервые процитировали в научной статье, а на одном из рынков предсказаний открылась ставка: дойдёт ли  до 0,01 к 19 ноября (стартовая оценка была в 40%).
Вторая неделя. Дальше всё-таки случилось плато. Проверенный рекорд простоял на  восемь дней, хотя репозиторий продолжал бурлить (18 октября приняли около двухсот пулл-реквестов, но они не изменили итогового результата), а в открытых PR Рохана Аруна лежали условные значения около
 .
Даже другие модели пытались участвовать: 17 октября у Аруна появилось объявление, что первую новую идею на этом плато предложила бесплатная модель из OpenCode (а именно MiniMax M3.1 Flash), а Claude Opus 5.5 её довёл до ума. Но через день последовало признание, что большинство идей бесплатной модели не прошли более глубокой проверки, а фронтирные модели “гораздо лучше сначала проверяют собственную работу”. Появилась и первая статья на arXiv о “гонке за κ” (Dağlı et al., с проверкой ключевого тождества в Lean 4), правда, с гораздо более скромным значением на своей собственной архитектуре.
А 21 октября стену пробил новый участник под ником zxv: пулл-реквест №4359 сделал вспомогательные массивы “продуктивными”, скомпилировал неравные задания вместе (концептуально это похоже на mixed-target recursion), и проверенный рекорд увеличился сразу больше чем на треть:
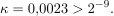
 по-прежнему ещё далеко.
Оговорки. Все эти результаты условны: они принимают на веру рукопись OpenAI, которую никто независимо не проверил. Lean-проверки в обоих репозиториях касаются только конечных сертификатов и арифметики неравенств, а не самого алгоритма; README так и говорит, что это не полная Lean-теорема об умножении. И, разумеется,  для реальной практики не сильно лучше
 : для чисел в миллиард бит
 , и
 .
Почему это интересный пример. Во-первых, это очень наглядная демонстрация того, что происходит с “низко висящими фруктами” после прорыва: первые константы в новом методе почти всегда чудовищно далеки от оптимальных, и когда появляется новый режим, прогресс в нём идёт на порядки в день, а потом упирается в следующую стену. Так было и с умножением матриц после Штрассена и Копперсмита–Винограда, только там между шагами проходили годы, а здесь — часы.
Во-вторых, посмотрите, кто во всём этом участвует. Далеко не только профессиональные математики и информатики: квант, бэкенд-инженер, десятки анонимных участников с подписками на Codex и Claude. Происходит та самая “демократизация”, о которой одни говорят с надеждой, а другие (например, цитированный выше Тасмин Чу) — с ужасом.
В-третьих, здесь на глазах формируется новая форма научной работы, которую Рохан Арун назвал децентрализованным автоисследованием: люди ставят задачу, пишут инструкции для агентов, рецензируют и сводят результаты, а поиск ведут модели. У Тимоти Гауэрса и Теренса Тао уже в конце нулевых были подобные проекты о массовом сотрудничестве в математике, только тогда людям приходилось думать самим.
И, наконец, в-четвёртых, это весьма конструктивный ответ на вопрос “что делать с нечитаемой рукописью”. Можно написать гневный пост, а можно взять её, положить в upstream/ и начать улучшать. Глядишь, через недельку выяснится, что в ней были спрятаны ещё пятьдесят порядков.
Вторая неделя
Первую версию этого текста я закончил 14 октября; за последнюю неделю появились, конечно, и новые интересные реакции. Коротко расскажу о главном.
Концентрация злости повышается
Первые реакции были всё-таки больше растерянными, чем озлобленными, но за неделю люди собрались с духом и написали уже по-настоящему резкие тексты.
Например, эссе Янниса Сакелларидиса «Paralysis» (написано в сентябре, но переработано 20 октября). Оно очень короткое, прочитайте лучше целиком. Главный тезис — что речь не о подчинении людей машинам:
it is not about subjugation of humans to machines, but to the owners of those: that’s why so many trillions of investment are flowing into AI.
Чтобы захватить научное производство, пишет он, машине вовсе не обязательно становиться сверхчеловеческой:
Maybe all it takes is vibes taking precedence over expert assessment, and a mathematical community in a state of paralysis.
Сакелларидис пишет, что провалились и AGMAI (“самоназначенный консультативный орган, неспособный определить, последовали ли его совету”), и Simons с $15 миллионами грантов (“мелкие подачки”), и филдсовские лауреаты (“формулирующие любительские предсказания”).
Хельмут Хофер из IAS в “Who Will Lead Mathematical AI?” рассказывает, что в американскую государственную программу Genesis Mission по AI в науке математику пришлось буквально вписывать по настоянию Японии, и упрекает научные общества (AMS, DMV) в том, что они “спят за рулём”:
We should not defend human mathematics by leaving the field. If mathematicians withdraw, the field will not remain empty.
А в гостевом посте у Тао под названием “This is normal bad work” Софи Хёйбертс спорит с самой идеей того, что это величайший день в истории математики:
These pdfs are exhaust fumes from their internal benchmarking effort. We do not need them to release this unprocessed exhaust into the atmosphere. <…> October 6th was not a watershed moment for mathematics. OpenAI’s droppings on GitHub are normal progress: normal for the current state of technology. Or at least normal for the available technology in 2 months from now. The only thing that is exceptional is OpenAI’s lack of shame for releasing poor quality work.
Пресса, разумеется, выбрала ту же интонацию: заголовок в Nature был “Mathematicians are up in arms“, и там Урсула Мартин из Оксфорда (соавтор Лейденской декларации) говорит, что OpenAI бросила сообществу черновик и “ждёт, что мы за ней приберём”; New York Times вынесла в заголовок цитату Тао о “военном положении”.
Письмо аспиранта
Центром второй недели на Proofs and Prompts стало открытое письмо анонимного аспиранта “Кто станет новыми математиками в мире Math 2.0?“. Автор собирается уйти из академии после защиты — не потому, что AI лучше решает задачи, а потому, что профессия “превращается во что-то неузнаваемое”, и хуже всего не сам релиз 6 октября, а то, с какой радостью его встретили старшие коллеги:
This struggle is not incidental to mathematical education. It is the principle way that education occurs.
I did not go to graduate school to organize, interpret, and curate an increasingly vast collection of mathematical results produced by machines.
…while you are discussing what your future will be, some of us have already decided that we no longer want to be a part of that future.
(«Math 2.0» — это термин Тао из его октябрьской лекции в Калтехе: Math 1.0 — математика дефицита доказательств, Math 2.0 — математика их изобилия, где люди занимаются изложением, синтезом и курированием.)
Письмо получило поддержку из самых высоких источников:
This is a wonderful essay, and I completely agree with it. <…> Many share the very same concerns — they are just not as vocal online. <…> I simply do not understand how we intend to nurture such things in PhD students when they rely on AI in their studies.
Это Петер Шольце, который просит автора передумать и указывает на Association for Human Mathematics и на новую AI-политику гостевой программы MPI в Бонне как на “очень маленький шаг” к тому, чтобы сохранить место для такой математики. В том же треде одни спрашивают, не ждут ли нас отдельные аспирантуры по “Math 2.0” и “Math 1.0”, другие замечают, что и Math 2.0 будет недолгой — курировать и объяснять AI тоже скоро научится, — а единственный голос, последовательно защищающий новый мир (магистрант ETH: “Math 2.0 мне нравится”, “математика не должна быть профессией”) получает в ответ ярлыки вроде “data labeler” и “вы защищаете неоправдываемое от имени олигархов”. Поляризация налицо, что, впрочем, неудивительно.
Вокруг письма за неделю выросла целая серия “Application season” для поступающих и ищущих работу:
- письмо Давида Мадора студенту (“если приход AI отвратит от математики многообещающих студентов, это будет самым большим вредом, который он нанёс дисциплине”);
- гостевой пост Альваро Лосано-Робледо у Тао с подзаголовком “Keep calm and carry on studying math”;
- рекомендации для аспирантов и научных руководителей, подписанные тридцатью шестью симплектическими геометрами (среди них Оро, Гинзбург, Китинг, Зайдель и Витербо).
But whatever your opinion, ignoring AI is not an option. <…> Be careful not to find yourself one-on-one with the AI.
Правила там простые: вести “лабораторный журнал” промптов и раскрывать его в диссертации, никогда не скармливать коммерческим моделям неопубликованные черновики соавторов без их согласия, сделать темы диссертаций более открытыми, а на защите показывать полное владение каждым результатом. Институты, пишут авторы, должны оплачивать подписки и железо, а руководители — не запрещать и не принуждать.
Франческо Маджи в гостевом посте у Тао формулирует, что именно сломалось:
the prevailing sentiment is that this traditional mechanism of recognition has effectively collapsed in a matter of weeks. A strong mathematical result, by itself, can no longer be taken as convincing evidence of a student’s independent mathematical abilities.
Вывод Маджи, впрочем, противоположен паническому: если мы не бросаем математику из-за того, что плохо записанные результаты “задевают наше антропоцентрическое представление о ней”, то обществу понадобится больше математиков, а не меньше, — “like… a lot more”.
Приоритет как бумажная корона
Тема, которая в первую неделю звучала намёками, во вторую стала программой. Томмазо Мораскини в «Contribution, Credit, and Community» пишет:
if there is a single thing that is clear to me in these confusing times, it is that we should abolish “priority of proof” <…> as an independent source of merit. <…> AI disclosures are strikingly unverifiable claims. <…> priority is turning into a paper crown.
Павел Этингоф и Слава Герович из MIT в «Mathematics of the Future» (вот полная версия в pdf) говорят то же самое об “ownership culture” в целом:
This culture is no longer sustainable. If LLMs do most of the heavy lifting, individual credit loses much of its meaning. <…> In the AI era, a theorem proved with heavy AI help should be valued equally to one proved without. Hiring committees should assess mathematicians, not the provenance of their theorems.
Предлагают они и конкретику: нанимать по докладам, интервью и длинным разговорам, а не по спискам публикаций; “диссертация не обязана содержать первое доказательство чего бы то ни было”; устные экзамены; “большую уборку” литературы с помощью AI.
Комментаторы, впрочем, эссе встретили в штыки, а один из них потребовал вынести на видное место дисклеймер со страницы 20: Этингоф с июля консультирует Anthropic на полставки (впрочем, там же сказано, что взгляды сложились раньше и с тех пор не менялись). Это тоже характерная черта механизмов поляризации: пристрастность стали искать у “своих”.
Самую интересную для меня формулировку даёт Тристан Бакмастер — тот самый, который про уравнения Навье–Стокса, — в гостевом посте у Тао:
Our credit system was built for the era of scarcity. Being first to a famous result was a reasonable proxy for depth of understanding, because nobody could get there without understanding a great deal along the way. That proxy no longer holds and so we will need new ways of assigning credit that are not simply correlated with access to resources.
Это почти дословно то, что я выше назвал законом Гудхарта, так что с выводами спешу согласиться. У Бакмастера есть и практическая часть: коллективные корпоративные соглашения с AI-компаниями с нулевым хранением данных и аудитом, обучение на данных пользователей только по явному opt-in, инвестиции в открытые модели. “Математика принадлежит молодым, они и решат, какой она станет”.
Противоположный полюс — Дейв Андерсон из Огайо в “Mathematics in the Dark Forest“: там публично воспроизводится эксперимент, который может повторить любой, — Claude и ChatGPT просят выбрать задачи из списка открытых проблем алгебраической комбинаторики и запускают автономно с промптами вроде “Keep going!”; две задачи “решились” за пару часов каждая.
My input was completely devoid of mathematical content. <…> Anyone can do what I did, and therefore many people will.
Рецепт Андерсона против “тёмного леса” (это из Лю Цысиня: цивилизации, которые прячутся, чтобы их не уничтожили) — не секретность, а наоборот: публиковать промпт, а лучше весь транскрипт, ценить доклады больше статей и осторожнее составлять списки открытых проблем, потому что такой список — приглашение для чужой LLM.
Переваривание началось
Теперь о хорошем. Лучший пример того, как выглядит “proof digestion” на практике, дал сам Тао. В релизе OpenAI было три статьи о нулях  -функций: две про квазигипотезу Римана (границы
 и
 , аналитические, через связь функции Мёбиуса с коэффициентами автоморфных форм) и третья, девятистраничная, которая не доказывала квазигипотезу, а напрямую исключала нули Зигеля — и почти целиком средствами алгебраической теории чисел и геометрии чисел.
За две недели её разобрали и упростили Уильям Бэнкс (arXiv:2610.15483, с помощью Claude), Брайс Керр и Бен Грин, а 19 октября Тао выложил набросок версии Грина — “адельного полиномиального метода”, где решётка многочленов от двух переменных вычисляется с кратностью на косой сетке, а определитель Грама зажимается сверху неравенством Адамара и снизу — делимостью. В комментариях Грин сообщает, что в тот же день получил четырёхстраничное доказательство от Джейкоба Пескадора и трёхстраничное от Кевина Баррето, и что готовится коллективная статья “в чём-то вроде традиционной формы, как version of record”. Девять страниц от AI превратились в три человеческих за две недели.
Тао при этом подчёркивает, что метод не инопланетный: это полиномиальный метод, “печально известный своей капризностью”, связанный с методом Степанова; ключевая лемма, как заметил Уилл Сэвин, восходит ещё к Сильвестру (то есть к середине XIX века), а Грину так и не удалось заставить ChatGPT найти на неё правильную ссылку.
Люди в целом даже поняли, почему это сработало:
In retrospect this makes sense, as the infamous “parity problem” blocks such methods from getting results such as (2) without some parity-breaking input: in this case, said input comes from the polynomial method, whereas in the QRH papers, it appears to be some (still poorly understood) automorphic miracle that is breaking the parity barrier.
Про сами статьи о квазигипотезе Quanta пишет, что Питер Сарнак перестроил свой семестровый курс под разбор доказательства и не будет называть результат “теоремой”, пока люди не проверят и не поймут все детали; Мацей Радзивилл уже умеет набрасывать аргумент на полстраницы, по рукам ходят человеческие изложения на 7–13 страниц, а “общее чувство — облегчение”. Семейство -функций, которое нашла модель, в 2002 году “едва не нашёл” Хенрик Иванец, а одним из ключевых ингредиентов оказалась формула Данна и Радзивилла 2021 года; специалисты, пишет Радзивилл, ошибались, считая, что их инструментов недостаточно. Джеймс Мейнард в Science описывает доказательство как соединение “не слишком мейнстримных” идей “исключительно умным способом”, а Джаред Лихтман в Quanta называет его самым значительным AI-достижением в математике “с большим отрывом”..
А 20 октября Тао запустил эксперимент “в духе Polymath, обновлённого для эпохи AI”: по каждому новому доказательству (квазигипотезы или отсутствия нулей Зигеля) извлечь с помощью AI явную верхнюю границу на гипотетический десятый дискриминант класса один — задачу, которую Хегнер решил в 1952 году другими средствами. Любое использование AI разрешено, лишь бы было раскрыто; “this is not a race”. И важное замечание:
The task of making each of these estimates explicit enough to create such a bound is rather tedious for humans. However, it seems eminently suitable for AI. <…> as both of these problems are already solved <…>, there is little risk of such a competition inadvertently disrupting an ongoing research project.
Обратите внимание на последнюю фразу: Тао действительно беспокоится о спойлерах. За полтора дня в комментариях появились десятки результатов: границы 50 000, 11 000, 653 при условии квазигипотезы с границей , 570 без неё, полное Lean-доказательство того, что список 65 “удобных чисел” Эйлера полон, и даже полное Lean-доказательство теоремы о классе один без методов Хегнера (людьми пока не проверено).
Бен Грин 21 октября написал там же, что ему “трудно убедить себя, что всё это — чистый плюс для математики”. Я бы сказал, что это ровно тот вопрос, на который эксперимент и должен ответить.
Новые институты
За две недели в инфраструктуре математики появилось больше нового, чем, кажется, за предыдущие десять лет.
- Деньги. Simons Foundation, OpenAI и Anthropic — $15 миллионов на понимание AI-результатов (см. выше); реакции на это, впрочем, были разными, от понятной благодарности до “мелких подачек” Сакелларидиса.
- Открытые модели. 16 октября стартовала SAIR Open Math OS — площадка с открытыми моделями (DeepSeek V4.1 Flash, Kimi K3, GLM 5.3 Flash) для математиков, с бесплатными академическими аккаунтами, обещанием не обучаться на данных пользователей и не гонять запросы через серверы AI-компаний, и планами дообучить собственную открытую математическую модель. Тао оценивает эти модели как отстающие от фронтира примерно на год и требующие примерно в сто раз меньше вычислений; сам он использовал SAIR-модель, разбирая статью о нулях Зигеля.
- Новый архив. Появился Hexagon — репозиторий препринтов, принимающий в том числе AI-сгенерированные работы, которые не подходят для arXiv; у каждой работы стоят метки вроде “Primarily AI-generated text”, “Human understanding: some parts”, “Lean formalization”.
- Новый журнал. Шаомин Гуо с коллегами объявляют о запуске журнала с двумя принципами: “понимание важнее первенства” и “строгость через формальную верификацию” — чтобы статью приняли, её доказательства должны быть проверены в Lean. Тао предлагает развивать и другие модели журналов.
- Коллективное переваривание. The Bourgain Project — попытка разобрать и изложить заново все пятьсот с лишним статей Жана Бургейна; Французское математическое общество запустило семинар “Math & IA à midi” (первый доклад от того самого Дюминиль-Копена); у Proofs and Prompts появились форум в Zulip и опросы.
- AI safety. Якоб Цимерман, филдсовский лауреат этого года, основал Mathematical AI Safety Institute (maisi.org), а Тимоти Гауэрс вошёл в его научный совет и написал длинный пост о том, насколько стоит бояться экзистенциального риска от AI. Главный вывод не будет удивительным для моих читателей: “Наверняка было бы лучше приостановить разработку и разобраться, как лучше всего использовать то, что у нас уже есть”.
И ещё одна реакция, которые близка моему собственному пониманию происходящего. Александр Буфетов спрашивает, не будет ли преувеличением сказать, что “западный институциональный идеал математика-исследователя уже несколько десятилетий тревожно похож на быстрого, технически безупречного бота для решения задач”. Говоря, что это не его идеал математика, он заключает: “Никогда за всю мою карьеру быть математиком не было так интересно”.
Яков Цимерман: уйти, чтобы заняться главным
Отдельно хочу рассказать о человеке, чья реакция на всё происходящее кажется мне самой последовательной и самой близкой лично для меня.
23 июля на Международном конгрессе математиков в Филадельфии Яков (Джейкоб) Цимерман из Торонто получил медаль Филдса. Медаль дали за две линии работ: гипотезу Андре–Оорта, на которую ушло лет двенадцать, и гипотезу Гриффитса, ещё около пяти. И в тот же день, прямо на сцене, он объявил, что уходит из математики в AI safety, в команду безопасности OpenAI. Боаз Барак, давно работающий там же, написал, что очень ждёт нового коллегу, хотя и «более чем немного смущён», а один из исследователей AI сравнил это с тем, как если бы Лионеля Месси наняли менеджером проектов.
В сентябре Цимерман стал ещё и научным директором нового независимого некоммерческого института MAISI (Mathematical AI Safety Institute), который занимается математическими основаниями безопасности мощных AI-систем. Исполнительный директор — его соавтор Эндрю Крич, в научном совете — Тимоти Гауэрс, нынешний президент AMS Рави Вакил, Джеффри Ирвинг и Пол Кристиано. Туда же теперь ведёт и сайт AI Safety for Mathematicians, который Цимерман сделал сам, чтобы математикам было проще прийти в AI safety.
В августовском докладе в Казани я назвал это самой радикальной реакцией на происходящее, которая мне лично очень нравится. И я до сих пор считаю, что это потрясающе. Цимерман давно об этом думает: ещё в 2025 году у них с Кричем вышел препринт с говорящим названием “A Taxonomy of Omnicidal Futures Involving Artificial Intelligence“, а в интервью он рассказывает, что когда вышел ChatGPT, он позвонил другу из AI safety и сказал:
You were right. I was wrong. This is gonna be the big deal of our lifetimes.
На медали Филдса выбит девиз “Transire suum pectus mundoque potiri” — “Подняться над собой и овладеть миром”. В интервью в “Theories of Everything” Курм Джаймангал спрашивает Цимермана, что из этого легче. Тот отшучивается, что стать лучше себя, пожалуй, проще, чем превзойти мир, а потом говорит серьёзно: филдсовскую медаль дают, чтобы поощрять будущие достижения.
I’m definitely trying to use, you know, this opportunity, which I’m very grateful for, to work on what I think is the most important problem, which is AI safety.
Использовать главную премию в математике, чтобы сказать “самая важная задача сейчас — другая”, и пойти её решать — по-моему, это и есть “подняться над собой”. AI safety — главная наука для человечества прямо сейчас, и умных людей не хватает катастрофически, а людей с математическим складом ума — особенно.
Воспользуюсь случаем, чтобы пройти по интервью поподробнее. Оно записано в начале августа, за два месяца до 6 октября, а читается так, как будто после.
Горевать можно. Начинается разговор с того, что Цимерман горюет и не скрывает этого:
a lot of my working identity is tied to sort of having year-long projects, decade-long projects sometimes, working at the edges, slowly figuring things out, having those aha moments, and I think that’s gonna go away. So there’s something about that that I think I’m definitely grieving.
Но тревожится он, по его словам, больше за математиков, чем за математику: прежде всего за молодых, которые шли в аспирантуру, рассчитывая на «business as usual». А на обвинения в пессимизме отвечает так:
when I’ve been saying these predictions of mine for a while now, that AI is gonna become robustly superhuman at the act of doing mathematics as we do it today, people often label me a pessimist <…> and really all I’m saying is that I think this will happen, and how society chooses to react is both a harder question and it’s also not set in stone. We have the power to decide.
Почему вы думаете, что AI этого не сможет? В интервью Джаймангал зачитывает пост физика Тобиаса Осборна (того самого, чья реакция есть в подборке Proofs and Prompts): ценность в новом равновесии сместится к тем, кто строит теории и придумывает хорошие определения, организующие быстро растущую область. Ответ Цимермана — ровно тот июльский вопрос Гауэрса, к которому я возвращаюсь ниже:
anybody claiming that the new equilibrium value will shift to X, I just find it strange that they’re so confident that AIs won’t also be able to do X. <…> for whatever role you think humans will play, you can just ask yourself why won’t AIs be able to do this as well?
Сюда же — его взгляд на то, что вообще составляет математику. Цимерман не согласен с популярным тезисом, что решение задач — малая и вспомогательная часть математики, а главное — понимание: по его мнению, решение задач для математики в её нынешнем виде центрально, а решение задач, построение теорий и поиск правильных определений — по сути, взаимозаменяемые навыки, которые питают друг друга.
А раз так, то и безопасной “чисто человеческой” ниши, куда можно было бы отступить, скорее всего нет.
Поезд едет. На вопрос, является ли доказательством Lean-сертификат, который никто не понимает:
I think pretty soon we’re gonna have proofs no one understands, and they’re going to underlie mathematics, and based on that mathematics, other things are going to work. So, you know, does a train run even if no one understands the mechanics by which it runs? Yes, it does. I mean, you can look at it run.
Цимерман признаёт, что многие его собственные теоремы опираются на результаты из теории моделей, доказательства которых он знает лишь в общих чертах и воспроизвести не смог бы. Значит ли это, что он не понимает собственную работу? Практически у любого математика будет так же.
Он вспоминает разговор с Чарльзом Фефферманом, случившийся, когда Цимерман был ещё студентом: знание всегда делится на три слоя — то, что знаешь досконально, то, о чём примерно представляешь, как оно устроено, и то, что можешь разве что назвать. И это нормально, лишь бы первый слой продолжал расти (и не стоит полагаться на слишком много чёрных ящиков, добавил тогда Фефферман).
Модели не инопланетяне. При этом Цимерман подчёркивает, что модели пока не пишут непостижимых доказательств: они строят на человеческой работе, а их идеи, пусть и умные, — того же сорта, что мы привыкли видеть. И делает из этого неожиданный вывод:
I feel like what we’ve seen should be a slight Bayesian update towards the idea that human cognition is not as arbitrary as you may have thought. Like, it seems like the patterns that we notice and the way that we choose to approach subjects maybe just is sort of the canonical way to think, or at least in part.
Мне кажется, это красиво дополняет тезис о “карте сложности”, который я ввожу ниже: дороги, по которым идут модели, вполне человеческие, просто люди по ним не решались идти.
Настоящая проблема — скорость. Главную трудность ближайших лет Цимерман видит не в непонятности, а в темпе: AI будет делать то, что люди сделали бы и сами, но настолько быстрее, что угнаться за ним станет невозможно. Пусть каждое отдельное доказательство в принципе можно понять — если в области за год появилось десять тысяч результатов, из которых выросли ещё пять областей, ни у кого не хватит на это времени. На Андре–Оорта у него ушло двенадцать лет, и это время ушло в том числе на то, чтобы как следует сориентироваться в области.
If projects start speeding up to the point where something like that takes, you know, a month or a week, then I have to reorient every week, and I just can’t do that. I don’t have the skill.
Сочувствие без отрицания. Мне очень близко, как он говорит о реакции коллег. Многие математики действительно в отчаянии и пишут об этом, но в ответ слышат злобное “математика никогда не была для вас”:
Should society not do something that’s better for the majority of people because mathematicians will lose their jobs? No, that’s not a good enough reason. But does that mean we have to respond with vitriol and not compassion? I don’t think so either.
Безопасность AI. И здесь мы переходим от математики к тому, куда Цимерман ушёл. Если для любой роли, которую мы придумаем людям, AI рано или поздно станет лучше нас, то вопрос уже не в способностях, а в том, как мы хотим устроить мир:
I think that unrestricted optimization is not going to be a sustainable strategy going forward. I think we’re gonna have to impose other restrictions on that. <…> uncontrolled just continuously making the AI smarter and ceding control to them, the moment they supersede humans in ability I think is a very risky proposition.
Люди, говорит он, вполне могут занимать роли, в которых они не лучшие, — просто потому, что мы люди и строим мир в значительной степени для людей. Отсюда и рецепт:
Kind of society has to make its own large-scale Manhattan Project. We need more theory work. We need more governments work. We need more social work to sort of navigate this transition. <…> it’s not gonna fall into our lap.
И объяснение собственного выбора:
If I didn’t think we’re about to enter a very turbulent transition, and I was confident that everything was gonna go well, I’d almost certainly just stay in academia.
Совет молодым. Новых аспирантов, кроме тех, кто прямо занимается AI, Цимерман больше не берёт: он не уверен, что может честно обещать им ту карьеру, к которой привык готовить.
Совет поступающим — заниматься тем, что любишь, но страховаться: разбираться в AI, изучать computer science, не закрывать глаза в надежде, что шум уляжется, и главное — сориентироваться заранее, пока это ещё не стало необходимостью.
Заканчивается интервью не алармизмом, а мечтой. Цимерман хотел бы, чтобы AI-репетитор объяснил ему химию, хочет играть в игры, придуманные AI, придумывать с его помощью кампании для D&D, писать мюзиклы (он их действительно пишет, а ещё занимается стендап-импровизацией):
I think we can get to a world where anything that you find fun you can focus on, and you’re not gonna be bottlenecked by the necessary sort of skill gaps that you have and you need to overcome.
И уточняет, что большинство людей, которые занимаются математикой, — вовсе не профессиональные исследователи: это дети, инженеры, люди, которым она просто нравится, и эта математика никуда не денется. К этому мы вернёмся ниже.
Глобально наши взгляды совпадают почти дословно. В человеческом уровне нет ничего особенного, и AI его пройдёт. На любой тезис “роль людей будет в X” надо честно спросить, почему AI не сможет X, и это . Пользоваться результатом можно, и не поняв его до конца. К тем, кто горюет, нужно сочувствие, а не насмешки. И главное: математика просто первая на очереди — “one of the first on the chopping block”, а продолжится это далеко за её пределами.
Поэтому самый последовательный вывод из всего, о чём этот пост, — не то, как переделать журналы и гранты (хотя и это важно), а то, что мы создаём системы, которые стремительно становятся умнее нас. Цимерман сделал из этого вывод лично для себя: нужно обеспечить безопасность таких систем. По-моему, это поступок, достойный лауреата филдсовской премии.
Что такое математика теперь
В своих докладах этого года (раз, два) я заканчивал тремя вопросами, на которые математическому сообществу придётся отвечать: что такое результат, чей это результат и зачем (и для кого) работают математики. В телеграм-посте неделю назад я написал, что главное — радикально меняется понятие “результата”, и любое новое его определение ведёт к серьёзным институциональным изменениям. После изучения реакций математиков я в этом только укрепился, но картина стала объёмнее. Попробую сформулировать, что я из них вынес.
Две точки консенсуса. Сообщество почти единодушно в том, что математика впечатляет, и почти единодушно в том, что оформлена она плохо. Вторую проблему проще всего исправить: нормальные тексты, нейтральный репозиторий, промпты, статистика неудач, деньги на семинары — всё это есть в рекомендациях AGMAI, и, думаю, следующие релизы (а ведь ясно, что это только первая партия) будут выглядеть гораздо приличнее.
Как доказательство может помешать? Вернусь к своему вопросу из сентября, потому что он, по-моему, не потерял актуальности. Если мы говорим, что смысл математики — в человеческом понимании, то как это понимание может ухудшиться от того, что появилось доказательство? Совершенно нечитаемое доказательство может не помочь. Но помешать-то как?
Более того, даже чёрный ящик, который выдаёт на любую гипотезу только бит “верна/неверна”, для многих важных гипотез сократил бы усилия живых математиков примерно вдвое, потому что очень часто непонятно даже, в какую сторону копать. Чу несколько лет думал о том, верно ли ; теперь ответ известен, интуиция подтвердилась, и думать можно о том, почему. И наоборот, мало кто верил, что оценку на умножение чисел можно сделать ниже  , и над этим люди вряд ли много работали; здесь даже простой бинарный ответ “да, так можно” наверняка бы очень помог людям.
В чём же тут дело? Что мешает с лёгкостью согласиться с тем, что
Мне кажется, что всё-таки математики немного… не кривят душой, конечно, но недоговаривают, когда ведут разговоры о том, что математика должна быть о человеческом понимании, или о том, что .
Две культуры. Ещё в 2000 году Тимоти Гауэрс написал эссе “The Two Cultures of Mathematics“. Название отсылает к знаменитой лекции Чарльза Сноу 1959 года о двух культурах, гуманитарной и естественнонаучной. Гауэрс предлагает простой тест: с каким из двух утверждений вы согласны сильнее?
(i) The point of solving problems is to understand mathematics better.
(ii) The point of understanding mathematics is to become better able to solve problems.
Первая культура — строители теорий. Её образец у Гауэрса — Майкл Атья, который говорит, что никогда не начинал работу с какой-то конкретной целью, “кроме цели понимать математику”. Вторая — решатели задач, и её образец — Пал Эрдёш. Он оставил миру огромное количество задач, но с построением теорий связан куда меньше. Гауэрс оговаривается, что речь о приоритетах, а не о том, что кто-то занимается только одним, и что математике нужны оба типа.
Эссе было написано во многом в защиту второй культуры (Гауэрс сам занимается именно комбинаторикой), и Гауэрс пишет, что организующие принципы в комбинаторике тоже есть, но это не точно сформулированные теоремы, а “general principles of wide applicability”. Нижняя оценка Эрдёша для чисел Рамсея, пишет Гауэрс, знаменита не тем, что у неё много приложений, не тем, что она трудна, и не тем, что закрыла давнюю задачу. Она знаменита тем, что открыла шлюзы вероятностным рассуждениям в комбинаторике. Разобравшись в ней, ты уносишь в голове принцип: если экстремальные примеры должны быть как-то равномерно размазаны, попробуй взять случайный. И этот основной принцип можно применить ко многим разным задачам.
Мне кажется, через эту оптику многое в реакциях на 6 октября становится понятнее. AI-модели первым делом пришли именно ко второй культуре. Задачи Эрдёша, единичные расстояния, двойное покрытие циклами — это ровно то, что Гауэрс называл “комбинаторикой” в широком смысле: задачи, которые разумно атаковать “more or less from first principles”.
Кстати, именно это имел в виду Михаил Вербицкий в посте, который я люблю цитировать в докладах про Vibemathed; здесь “второкультурное” — не ругательное слово, ну то есть ругательное только для самого Вербицкого:
Строители теорий могут сказать (и говорят! вспомним письмо филдсовских лауреатов), что решение задач всегда было лишь прокси-метрикой для нового понимания. А решатели задач так сказать не могут, не отказавшись от самих себя. Не случайно Гауэрс это письмо не подписал, а Цимерман, о котором речь пойдёт ниже, называет себя “скорее решателем задач”.
Что же теперь изменилось? Главное, что на самом деле изменилось, — это то, что логику о том, что главное в математике, теперь приходится делать явной. Вынести на знамя и говорить именно о ней, а не о прокси «кто больше доказал».
Человек перестал быть основным средством доказательства теорем. Представители “второй культуры” всё ещё могут говорить, что из решённых задач ещё нужно извлечь тот самый “general principle”. Но в любом случае измерять “качество” математиков через доказанные теоремы уже больше не получится никогда.
Омер Рейнгольд соглашается со мной здесь:
We cannot suddenly move the goalposts and pretend that proving theorems was never the point, or that our open problems were merely proxies for building mathematical understanding. Those theorems are still of deep interest, and studying their proofs remains central to how we gain understanding in the first place.
И Кевин Баззард в своём посте тоже с некоторым ехидством замечает: ещё несколько лет назад большинство математиков согласились бы, что главные премии дают тем, кто доказывает самые трудные теоремы, а теперь мы вдруг тратим много времени на объяснения, что на самом деле премии дают за самое глубокое понимание. В каком-то смысле это действительно “moving the goalposts”; у сдвига ворот вообще богатые традиции в искусственном интеллекте.
С другой стороны, эксперты всегда знали, что теорема Уайлса ценна не тем, что закрыла задачку Ферма о степенях целых чисел, а тем, что открыла в программе Ленглендса. Но раньше теоремы и понимание практически всегда шли в одной упаковке, а считать и превозносить конкретные результаты было проще.
И что теперь? Как мне кажется, этот конкретный фазовый переход совершенно не страшен ни для математиков, ни тем более для математики. Ну да, потребуются новые метрики, но понимание всё ещё остаётся пока человеческим делом.
Однако уже сегодня из этого следуют институциональные изменения, и серьёзные. Мы больше не можем строить систему на том, кто больше доказал теорем, и давать за это премии, гранты и позиции. Всё это придётся привести в более точное соответствие с тем, что мы на самом деле ценим.
И здесь стоит отметить, что наши институты вообще довольно лицемерны, не только в математике. Не со зла, а потому что и бюрократам, и просто “обычным людям” нужны метрики, если речь о том, в чём человек сам глубоко не разбирается, а разбираться во всей математике невозможно уже лет сто.
Отсюда и сплошной гудхартинг в наукометрике: число статей, индекс Хирша, список решённых именных гипотез.
Одно из ближайших следствий прихода AI в науку, как мне кажется, именно в том, что это лицемерие нам, людям, придётся подвыправить, — и это в целом-то замечательно!
Кстати, конкретно в математике лицемерия было меньше, чем где-либо: доказательство теорем действительно было важнейшим занятием математика. Гудхартинг выражался всего лишь в том, что остальные занятия, не менее важные — построение теорий, постановка вопросов, объяснение, — во всех формальных контекстах были подчинены этому “доказать побольше”.
Заметьте, что речь даже не о “опубликовать побольше”: публикации никуда не денутся и в мире чистого theory building и proof digestion. Речь о том, каково главное содержание этих публикаций. Некоторые авторы из подборки реакций — Марко Мораскини, Маттиа Галеотти и другие — говорят то же самое: академия сама подчинила всё метрикам, и 6 октября — поражение в первую очередь этой системы.
А для человеческого понимания и для освоения новых фронтиров математики новые инструменты, кажется, не несут ничего плохого, кроме хорошего. Если кто-то построил ледокол, мы можем заплыть на нём дальше на север, и какая разница, сами ли мы кололи лёд ломом или это сделала “бездушная машина”? Это, в сущности, позиция Баззарда, который призывает “отпустить машины, посмотреть, где они остановятся, и начать путешествие туда”, и его же: математика бесконечна, а экспоненциальный рост — нет, так что где-то дальше нас ждёт новая “естественная граница”, и за ней начнётся новое приключение. Он, кстати, заканчивает пост словами Гильберта, которые я тоже люблю цитировать:
Wir müssen wissen — wir werden wissen.
Мне не очень понятно, что имеют в виду люди, которые говорят, что “карьеры тысяч математиков разрушены”. Карьера не может зависеть от доказательства теорем в мире, где доказательство теорем вообще не делается человеком. Очевидно, что изменятся именно институты, и мы переопределим понятие “карьера математика”, потому что у нас просто не будет выбора: продолжать пользоваться старыми метриками не получится.
Как именно переопределим — вот это действительно вопрос на миллион. Готового ответа у меня нет, но именно это и надо обсуждать, а не то, как заставить OpenAI не решать наши задачи.
Контраргументы. Я ответил на вопрос о понимании, но это не все вопросы, и реальные контраргументы к моему оптимизму, конечно, существуют.
Первый — как бы ни устаканились институты в результате, будет и неприятный переходный период: кому-то, как мы видели выше, на следующей неделе сдавать заявку на грант, и у этого кого-то действительно не так много опций прямо сейчас.
Второй — тот, который сам Баззард задаёт сторонникам “математики понимания”: куда мы отступим через год, когда AI будет не только доказывать теоремы, но и прекрасно их объяснять? Гауэрс задавал этот вопрос ещё в июле: “Почему вы думаете, что AI не сможет и этого?” Ответа на него, разумеется, нет и быть не может.
Баззард, кстати, признаётся, что сам не согласен с Тёрстоном: для него математика — это доказательство теорем, построение теорий и постановка гипотез; число доказанных теорем хотя бы можно измерить, а понимание — понятие туманное. То есть даже среди AI-оптимистов нет согласия в том, куда именно мы движемся.
А сам Тимоти Гауэрс не подписал и письмо филдсовских лауреатов — именно потому, что не согласен с тезисом “решение задач — лишь инструмент и прокси для понимания”: он не хочет объяснять коллегам-“решателям”, что у них неправильная математика. Зато он уверен, что вся существующая система измерения заслуг скоро рухнет сама:
Very soon, the whole “credit system” will surely collapse, since finding an amazing proof will be no more of an intellectual achievement than when a citizen scientist spots through their telescope an object that turns out to be a new comet.
А Джон Баэз в комментариях там напоминает о том, о чём Гауэрс не написал: все молодые математики, которых он знает, беспокоятся не о том, потеряют ли они интерес к математике, а о том, будут ли для них рабочие места.
Два удовольствия. Клэр Бюррен напоминает слова Жан-Пьера Серра, сказанные New York Times:
Mathematicians take pleasure in doing maths in two different ways: learning and finding new things. Hence a conflict: A.I. increases the first pleasure and lowers the second one. The problem is it may lower the pleasure too much; that is especially serious for young mathematicians.
В подборке реакций это отлично видно: те, кто в восторге, в основном хотят узнавать новое, а грустят прежде всего те, кто любит находить или быть первым. Бридсон, президент того самого Института Клэя, которому предстоит решать судьбу премии за Навье–Стокса, пишет об этом так:
But for me, and I suspect for most of us, there is a greater joy in discovering and then sharing something that is new to humanity. If the role of a typical mathematician were reduced entirely to explaining the output of others (humans or machines), this greater joy would be lost and being a mathematician would be a less appealing vocation.
А у Скотта Ааронсона на этот счёт своя великолепная метафора:
If you want some sense of what things feel like now in math, imagine a hunter-gatherer who’s spent his entire life learning to survive deep in an unforgiving rainforest, then a giant resort hotel springs up right next to him with a helipad and heated pools and AirBnBs, and without missing a beat, the hunter-gatherer says: “alright fine, so now my new job is to run wilderness retreats for the tourists, or something.”
Шахматы и спортзал. В докладах я спорил с популярным сравнением с шахматами: шахматы не умерли от того, что компьютеры давно играют лучше людей, но шахматы — это соревнование людей с людьми, а математика — наука, в которой есть объективные результаты.
Если бы существовала “наука о шахматах”, где исследователи ищут лучший ход в позиции, места для людей в ней давно бы не было. Я и сейчас так думаю, если говорить о математике как о профессии, производящей новое знание.
Но среди реакций встречается и другой взгляд. Джайлз Гардам переворачивает привычную формулу:
It’s not that mathematicians exist to produce mathematics: mathematics exists to produce mathematicians, at all levels, from school children to professional researchers.
Рубен Даан в соседнем посте того же блога пишет, что продукт математики — это не только доказанные теоремы, но и сам математик.
В посте о мотивации я писал, что AI может построить нам самый современный спортзал, но мотивацию придётся приносить с собой. Похоже, это относится не только к студентам. Штангисту не мешает то, что погрузчик поднимает больше.
Есть, правда, некоторая проблема в том, кто будет платить за спортзал. Нюберг-Бродда спрашивает, кто и зачем будет платить математикам за радость учиться. Бюррен — что отвечать грантовым комитетам на вопрос: “Разве AI ещё не решил математику?” Изабель Дальгрен трезво замечает, что математики приносят обществу пользу прежде всего как преподаватели, а не как живые сертификаты человеческого понимания, и что спрос на исследовательскую математику не так уж велик. А Энн Томас пишет, что руководство одного из старейших и богатейших университетов уже открыто обсуждает замену лекций AI-тьюторами.
Публичным оправданием профессии всегда были результаты; если математика становится спортзалом для ума, ей понадобится новая история о том, зачем она обществу. И эту историю ещё предстоит написать. А может, благодаря AI-революции и писать не придётся…
Натуралисты. Есть и ещё один сдвиг, который мне кажется интересным именно с научной точки зрения.
Жан-Кристоф Мурра пишет, что математики становятся натуралистами: бесконечное пространство строгой математики, которое раньше ощущалось как то, что мы кропотливо строим сами, начинает ощущаться как уже существующая природа, которую надо изучать. Чжоу Фэн мечтает о “Google Maps для математики”, по которым можно путешествовать между идеями и доказательствами.
И нередко эта природа оказывается не такой, как мы думали. Филлип Харрис пишет, что AI, возможно, показывает нам, что ландшафт математики более плоский, чем казалось, и некоторые из наших любимых вершин — на самом деле пологие холмы. Автор твита про  , который мы цитировали выше, в ужасе ровно от этого. Калегари был уверен, что аналитические методы упёрлись в потолок, — и ошибся.
Игнаси Мунде задаётся вопросом, не была ли красота математики вообще связана с нашими ограничениями: медленный темп позволял замечать то, что на большой скорости проходит мимо.
Я бы сформулировал так: карта сложности математики оказалась во многом картой нашей психологии. Я уже писал об этом по поводу единичных расстояний и двойного покрытия циклами: эти решения находились там, куда эксперты не смотрели, потому что “было понятно, что это направление вряд ли может сработать”. Якоб Цимерман тогда заметил, что AI-системы способны дольше играть в более опасных водах, не теряя присутствия духа.
Шестое октября показало это в промышленном масштабе, и история с умножением чисел — здесь один из самых ярких примеров. Какие-то задачи были сложными для людей не потому, что они объективно гораздо сложнее других, а потому, что людям было страшно, долго или скучно идти туда, где лежало решение.
Это интересное новое знание о самой математике — и, может быть, один из самых интересных “результатов” релиза OpenAI.
За пределами математики. В телеграм-посте я написал, что пока говорю о математике, потому что там это уже случилось, но другие науки ждёт то же самое. Ганс формулирует это так: математики — первая большая группа, которая почувствовала на себе эту волну, а за ними в ближайший год пойдут почти все работники умственного труда. Митчелл Тейлор называет математику показательным примером для всего общества. Григорий Аврамиди просит коллег стать для мира надёжными свидетелями: рассказать, что мы видим и с какой скоростью это происходит, — и что дело не в наших рабочих местах и не в хайпе. А Эндрю Карран в X просит не смеяться над математиками: каждого из нас однажды ждёт то же самое.
Стив Сюй возражает, что если бы делом твоей жизни было лечение рака, внезапный ответ от AI вызвал бы только радость. Наверное, это так и есть: медицине нужен ответ: лекарство и есть продукт. А в математике ответ никогда не был главным продуктом; главными были путь, понимание и люди, которые его прошли. Поэтому чем больше ценность профессии заключена в самом процессе, тем больнее ей будет, когда процесс исчезнет или изменится до неузнаваемости.
Заключение
Я по-прежнему неисправимый AI-оптимист в отношении математики: результатов, которые появились в этом году, хватит на целое поколение математиков, и почти никто из комментаторов не сомневается, что это настоящая математика. Слоп-изложения и плохие манеры — наименьшая из возможных проблем.
Настоящая задача математического сообщества — не заставить компании перестать решать наши задачи (это и невозможно, и контрпродуктивно), а честно сказать, что мы ценим на самом деле, и перестроить под это институты.
Уже через неделю-другую после исторического релиза на вопрос “что дальше?” начали появляться если не ответы, то хотя бы направления ответов: открытая модель для математиков, архив для AI-препринтов, журнал, в который нельзя подать статью без Lean, пятнадцать миллионов на семинары, Polymath-проект, в котором агентам можно всё. Девятистраничное доказательство от модели за две недели превратилось в трёхстраничное человеческое.
А линия раскола переместилась с границы “математики против OpenAI” внутрь сообщества, между теми, кто рад новой математике, и теми, кто не хочет становиться её куратором. Второй конфликт, боюсь, будет жить дольше первого.
Свои доклады “Vibemathed” я заканчиваю историей из автобиографии Бертрана Рассела:
There was a footpath leading across the fields to New Southgate, and I used to go there alone to watch the sunset and contemplate suicide. I did not, however, commit suicide because I wished to know more of mathematics.
Заметьте: не открыть, а узнать. Это первое из удовольствий Серра, и 6 октября его никак не отменило — скорее наоборот, узнать теперь можно гораздо больше. А вот как сохранить второе удовольствие, радость охоты, и как объяснить обществу, зачем ему платить людям, которые теперь в основном будут узнавать и понимать ответы, а не находить их самостоятельно, — на эти вопросы нам пока ещё предстоит ответить.
Но тем интереснее звучит мой вечный вопрос. Что дальше, коллеги?
Сергей Николенко
P.S. Прокомментировать и обсудить пост можно в канале «Sineкура»: присоединяйтесь!